Rust 的依赖关系吓到了我
出于好奇,我运行了 toeki 这款用于计算代码行数的工具,发现 rust 代码竟然有 360 万行之多。删除供应商提供的软件包后,rust 代码减少到 11136 行。

我并不自诩比经常在这里写博客的顶尖工程师更有经验或理解力,但我确实感到困扰。我热爱 Rust。它是我最喜欢的编程语言,我喜欢它的社区和语言设计。在我的日常工作中,我已经能够将它应用到适合的项目中。

Rust 的依赖关系开始让我感到担忧。对于那些不使用 Rust 编程的人来说,Rust 通过 crates.io 提供了一个 crates 生态系统,用户可以使用 cargo add 命令或简单地将所需的 crate 和版本添加到 Cargo.toml 文件中来安装它们。这种模式与 nodejs 的 NPM 类似。
优势
Cargo 非常实用且极大提升了开发效率,让我无需像使用 CMake 那样手动查找并链接文件。这还让我能够频繁地在不同架构和操作系统之间切换,主要是在我的 M1 MacBook Air 和 x86 Debian 桌面电脑之间。总体而言,我无需过多考虑包管理,可以直接投入编码工作。
缺点
不仔细考虑包管理会让我变得马虎。在最近的一个生产项目中,我引入了许多其他 Rust 开发人员使用的 dotenv crate。它运行了数周,直到最近检查 Rust 安全公告时发现 dotenv 已 未维护。下面是一个建议的替代方案 dotenvy。整个事件让我思考……我到底是否需要这个 crate?35 行代码后,我得到了我需要的 dotenv 部分。在每种语言中,包都会出现维护不善的情况,而引入一个可以说是微不足道的依赖项是我自己的选择。那么,当我有真正需要的依赖项时会发生什么情况呢?
如此多的代码

Tokio 是 Rust 有史以来维护最好的软件包之一。它与 axum 一起被添加到 Tokio(异步运行时)之上,axum 是一个由同一组人开发的 Web 服务器。Tokio 是我用过最酷的东西之一,它自诩为一个“偷工减料”的多线程运行时。Tokio 的表现远超我的预期。
因此,我决定添加几个我认为必要的依赖项,使我的 Cargo 文件总数达到以下内容:Axum、Reqwest、ripunzip、serde、serde_json、tokio、tower-http、tracing 和 tracing-subscriber
总体而言,我认为这个项目相当简单,只是一个处理请求、解压文件并记录日志的 Web 服务器。
为了构建更健壮的软件,我决定使用 Cargo 的“vendor”功能,将所有依赖项下载并本地托管。
出于好奇,我运行了 toeki 这款用于计算代码行数的工具,发现 rust 代码竟然有 360 万行之多。删除供应商提供的软件包后,rust 代码减少到 11136 行。

现在我明白,Web 服务器是复杂的,而一个完整的异步运行时更是复杂。然而,根据这篇 Register 文章,整个 Linux 内核只有 2780 万行代码。
这仅占我项目代码的7%……
我该如何审计如此庞大的代码量?
我亲自编写的代码仅约1000行

解决方案是什么?
我毫无头绪…… 许多人呼吁像 Go 一样为 Rust 标准库添加更多内容,但这会带来一系列问题。Rust 定位为一种高性能、安全且模块化的语言,旨在与 CPP 和 C 竞争。这意味着它针对的是嵌入式设备等。添加到 std 库中的每项新内容,都是 Rust 团队需要管理和处理的一项新任务。仅 Tokio 本身就拥有我见过的最活跃的 Github 和编程 Discord 之一。
我无法重写世界,异步运行时和 Web 服务器对我来说太过复杂且耗时,无法为这样的项目投入开发(尽管我最终应该这样做以加深理解)。
在 Cloudflare 的面试中,我提出了一个问题,他们告诉我,云飞拉和其他人一样,只是利用了tokio,并从crates.io中提取。他们多久审核一次代码?
Clickhouse提到了二进制文件大小的问题,我怀疑他们甚至没有相同数量的crates。
使用 cargo 时,(据我所知)没有简单的方法可以查看哪些行实际上被编译到最终的二进制文件中,许多 crates 包含我不一定需要的 Windows 项目(但没有官方的方法可以告诉 cargo 这一点)。
现在,我向大家提出一个问题:我们该怎么办?
本文由 TecHug 分享,英文原文及文中图片来自 Rust Dependencies Scare Me。
共有{571}条精彩评论
我认为,任何一个系统如果让引入依赖变得“容易”,且不会因规模或成本而受到惩罚,最终都会导致依赖问题。这正是我们今天在开源语言的语言仓库以及私有单仓库中面临的状况。
这在一定程度上源于过去40年软件分发方式的演变。在80年代,功能库是一种需要付费购买的资源,开发者不得不将其拆解并谨慎地整合到受限于磁盘空间的环境中(例如软盘)。你可能需要拆解该库,提取所需部分,并将其集成到构建中以尽可能缩小体积。
如今,我们层层叠加库文件。只需简单地输入import foolib,然后调用foolib.do_thing()即可开始运行。谁会在乎foolib中到底包含了什么。
在每个层级,调用者可能只需要某个依赖项5%的功能。依赖树越深,浪费就越多。最终,你可能会发现,你的简单二进制文件包含了500 MiB的代码,而你从未实际调用过这些代码,仅仅是因为你引入了那个用于格式化数字的依赖项。
在某些情况下,语言会使情况变得更糟。例如,Go 和 Rust 鼓励将单个包/模块的所有内容都放在同一个文件中。添加可选功能可能会很麻烦,因为这需要创建新模块,但如果你只想使用模块的一小部分,该怎么办呢?
我能想到的唯一真正解决这个长期问题的办法是超精细的符号和依赖关系。每个函数、类型和其他顶级语言构造都需要声明其运行所需的符号集(其他函数、符号、类型等)。当你依赖某个符号时,它可以按需构建所需的精确符号图,并丢弃给定库中的其余部分。最终,你将获得实现所需功能的最小代码集。
这是一个糟糕的主意,我非常讨厌它,但除此之外,如何解决当前这种从依赖项开始构建整个代码宇宙,然后像拖着死代码的船锚一样拖着它的设置呢?
> 我认为,任何系统中,如果依赖项的引入是“容易的”,且没有大小或成本的惩罚,最终都会导致依赖问题。
Go 和 C# (.NET) 就是反例。它们都有很好的生态系统,而且与 Rust 或 JS (Node) 一样简单且有效的包管理。但 Go 和 C# 都没有像 Rust 甚至 JavaScript 那样面临依赖地狱的问题,因为它们有出色的标准库,甚至还有像 ASP.NET 或 EF Core 这样的大型框架。
一个优秀的标准库显然是解决方案。一些 Rust 的支持者以 Python 为反例来贬低它。但 Go 和 C# 再次证明他们错了。一个优秀的标准库是一个解决方案,但需要巨大的努力才能实现,只有像 Google(Go)或微软(C#)这样的大型组织才能做到。
不,不是这样。
强大的标准库解决了语言本身关注的问题。对于C#和Go来说,这就是Web应用。
尝试在其他领域使用它们,依赖关系就会开始堆积(如游戏、桌面应用),或者它们基本上被闲置(如嵌入式系统、手机、WebAssembly)
> 一个庞大的标准库可以解决该语言所关注的问题
这是其中的一部分,但它还可以解决审查的问题。当我使用 Go 标准库时,我不需要像查看 crate 或 npm 包时那样亲自花时间进行审查。
一般来说,github 上的 Go 和 Rust 包质量很高,但操作系统包与被批准成为语言自身 stdlib 的一部分的包之间仍然存在明显差异。
很高兴知道,在库发布之前,数千家不同的公司已经为我发现了问题,或者在评论中提出了反对意见。
“Web 服务器”是一个相当大的用例。
但我同意图形在标准库中常常被忽视。不过这有点不同。标准库通常处理操作系统提供的内容。图形可以说是一个独立的世界。
至于Wasm:首先,这是运行时问题而非语言问题。我认为Wasm的垃圾回收(GC)已在路线图中。其次,Go和C#显然早于Wasm出现。
归根结底,并非每种语言都应关注所有用例。更关键的问题是,它是否为目标程序类别提供了标准库。
以具体例子而言:JS在高效便捷地生成动态HTML方面并不出色。你可以通过减少依赖或使用一些巧妙的模式走得很远。但如果它能提供一些开箱即用的功能,将会节省大量时间和精力。
> “Web 服务器”是一个相当大的用例。
你认为游戏、桌面和移动应用程序不是大的用例,每个都是数十亿美元的行业?
我不知道,我觉得你是在故意曲解问题,故意忽视athrowaway3z所说的话:在那里它能正常工作,是因为那些语言本质上就是专门为支持网页开发而设计的。这就是为什么它们的标准库在这个领域已经足够用了。
我能理解网页开发可能是你唯一关心的事,这确实是个庞大的行业——但“大型标准库能解决依赖问题”的论点其实并不成立,因为几乎所有其他应用场景都证明了这一点。
> 但“大型标准库能解决依赖问题”的论点并不成立,因为几乎所有其他应用场景都证明了这一点。
我认为依赖问题无法通过优秀的标准库完全解决,但确实可以通过某些语言的实践来缓解。
我认为 JavaScript 是一个非常典型的案例。
网络规模可能比所有这些加起来都大。而且如今移动和桌面应用的大部分都依赖于网络技术。
具体来说,这些语言专注于后端开发,因此约占开发者的28%。55%专注于前端开发。如果将游戏、桌面和移动应用加起来,奇怪的是也得到28%的结果。所以,它并不是更大,而是同样大,直觉很准确!这排除了嵌入式 8% 和系统(8-12%)。这些可能是 Rust 更常用的领域。显然存在重叠,我们还没有提到数据库和科学编程,它们分别占 12% 和 5%。
编辑:重读后,我觉得自己可能有些讽刺,我真的很佩服,没有查资料就能如此准确地估计出比例。作为回应,这有点离题。因此,我要补充一点,如果 Rust 没有选择排除电池,它就永远不会像 Tokio 那样具有良好的异步性,也不会像 Embassy 那样在嵌入式系统中实现异步性。考虑到它最初作为桌面/系统语言的重点,我认为这是正确的决定。正是由于人们不断添加新功能,它才得以超越了最初的定位。使用 cargo-deny,固定最旧的版本,该版本能够满足你的需求,并且不会出现 cargo deny 错误。仅 rust lang repo 就引入了数百个 crates,如果你只审查该列表之外的内容,也可以节省一些时间。
“Web服务器”本质上是将数据库转换为JSON和/或HTML。其中确实存在复杂性,但与其他领域相比,这并非什么独一无二的浩大工程。
并非所有 Web 服务器都处理 HTML 或 JSON,许多服务器甚至没有外部数据库,仅用于管理内部状态。
即便忽略这一点,这些也只是常见格式。它们无法说明特定 Web 服务器正在执行什么功能。
以 Go 语言的一些项目为例,它们要么是 Web 服务器,要么将 Web 服务器作为核心组件,如 Caddy 或 Tailscale。这些项目类型差异极大。
我猜“Web服务器”这个概念需要扩展到包含通用网络功能,而这正是Go标准库支持的典型用例或类别,这也是我最初的观点。
> “Web服务器”基本上就是将数据库转换为JSON和/或HTML
你对“Web服务器”的定义似乎与我截然不同。
为了澄清这个困惑,术语“Web服务器”通常特指监听HTTP请求的软件,如Apache或Nginx。我会用“应用服务器”来指代处理Web服务器发送给它的请求的进程。我将他们评论中的“Web服务器”理解为“应用服务器”,这样说通了。
是的。这是我预期中的区分。不过我不确定数据库相关功能是否通常应由应用服务器本身承担。
可能是语言社区的习惯。
啊,是的,我确实指的是“应用程序”。你关于“应用服务器”不适合处理数据库连接的观点是正确的。
实际上,.NET 对于游戏和桌面应用程序也不需要太多依赖项。
那么它是否自带良好的渲染器、物理引擎、本地化支持、输入控制器和游戏内界面?
你列出的库太过专业化。而且它们需要与资产管道集成,这完全超出了编程语言的范围。
至于通用功能,我认为C#是唯一一种在标准库中包含小向量、3×2和4×4矩阵以及四元数的主流语言。
> 我认为C#是唯一一种在标准库中包含小向量、3×2和4×4矩阵以及四元数的主流语言。
它们提供了SIMD加速的3D投影矩阵计算方法。一旦深入细节,其他生态系统根本无法与之匹敌。
公平地说,没有哪种编程语言的框架能包含所有这些功能……除非你使用的是像Unity/Unreal这样的游戏引擎。
如果你愿意将自己限制在2D游戏领域,并且排除物理引擎(假设你只使用Box2D的绑定库)以及UI(2D游戏开发者通常会自行开发UI系统)…… 那么在C#世界中,你的最佳选择是Monogame(https://monogame.net/),它在桌面和主机平台上发布了许多成功的作品(如《星露谷物语》《Celeste》)
> 公平地说,没有哪种语言的框架包含所有这些功能。
这要看情况。Godot Script就是一个例子,因为它自带游戏引擎。
但最初的论点是
> 实际上,.NET开发游戏和桌面应用时也不需要太多依赖项。
如果你指的是带有大型游戏引擎的语言,这本身就是一个矛盾的论点。拥有优秀游戏引擎的语言,自然会配备优秀的引擎。
但通用编程语言即使包含了最好的利基库,也几乎得不到任何好处。想象一下,如果 C++ 随 Unreal 一起发布。
这些是非常专业的依赖项。而在 Rust 中,我们谈论的是 serde,它包含在许多主要语言的标准库中。
你真的想将 serde 与渲染引擎进行比较吗?
>一个优秀的标准库显然是解决方案。一些 Rust 的支持者以 Python 为反例来贬低它。
Python 的标准库非常庞大。我不会说它很优秀,因为 Python 已经存在了 30 多年,很难向标准库添加内容,更难删除内容。
虽然会不时添加新内容,但目前库中的一些东西确实显得过时了。
我仍然希望我们能获得一个类型良好的 argparse,搭配现代 API(这对没有依赖的小脚本来说好太多了!)
我很感激 argparse 存在于 Python 的标准库中。但参数解析对于简单程序来说并不难。程序员应该花点时间思考并自行解决,而不是总是依赖第三方库,否则就会陷入依赖地狱。
特别是参数解析,这是一个很好的起点,让你意识到可以实现所需功能而无需添加一堆依赖项
强烈反对。标准化标志解析对我们所有人都是福音,我们不想被迫去猜测作者选择了哪种标志约定来实现,就像在非 getopt C 程序中那样。
我不反对这个原则,确实有很多无用的 Python 依赖项,但自己实现参数解析并不是解决办法
再次强调,参数解析大多数时候并不难。你不需要制定自己的约定。那只是奇怪。
如果你从未考虑过这个问题,可能会觉得需要一个现成的依赖项。但作为程序员,有时我们应该在做出决定前多思考一下。
参数解析正是那种如果标准库未提供时我会选择第三方库的情景(在Python的情况下,甚至可能即使标准库提供了也不用——argparse有一些非常令人不快的行为)。当你查看库代码时,它可能看起来比你自己编写的多得多,而且确实如此。但在概念层面,你很可能最终会使用其中很大一部分,或者至少看到未来使用的可能性。而且它通常不会引入太多依赖项。(例如,click 只需要 colorama,而且仅在 Windows 上需要;而且似乎不会引入任何间接依赖项。)
对于像 Numpy 这样的重量级依赖项,情况就大不相同了(这些依赖项包含大量测试、文档和头文件,即使在人们仅将其作为其他项目的依赖项安装的轮子中也是如此,并且涵盖了真正广泛的功能范围,包括为可能只想乘法一些小矩阵或高效表示图像位图的人提供 BLAS 和 LAPACK 接口), 或者更复杂的依赖项,它们会引入与你的项目完全无关的多个组件,这些组件在运行时永远不会被使用。(Rich支持终端中与文本相关的各种操作,我猜大多数用户可能只希望实现其中一种功能。)
你可以这样做,但总会有权衡。一旦我添加了大约第三个参数,我总是希望自己当初直接使用库,因为我不是被雇来重新发明轮子的。
当然。这就是你得到 leftpad 和依赖项“供应链”问题的缘由。
你真的在把 clap 和 leftpad 进行比较吗?
虽然 Python 的标准库并非所有内容都出色(我指的是 urllib),但我认为大部分都足够好用。Python 仍然是我最喜欢的语言,正是因为这一点。
也许 Python 4 只会移除一些东西。
我的个人语言设计深受我对 Python 4 的想象启发(但也借鉴了其他语言的元素,以及一些完全新的想法,这些想法在 Python 中可能无法完美适配)。
> 但 Go 和 C# 都没有像 Rust 甚至 JavaScript 那样面临依赖地狱的问题,因为它们拥有卓越的标准库。
它们的使用范围也更窄,这意味着更容易创建大多数人都能使用的标准库。使用更通用的语言无法做到这一点。
我认为 C# 在微软几乎被用于所有领域,包括 GUI、后端、DirectX 工具(新的 PIX UI、Managed DirectX 和 XNA,在 Creative Arcade 时代)、Azure 等,与 C++ 一起使用,即使微软 <3 Rust,其使用数量也更大。
我不明白嵌入式系统的论点。仅仅因为标准库很大,并不意味着它会全部包含在编译目标中。
确实,这与二进制大小无关,因为其中没有任何内容会被包含。如果你从标准库本身就无法使用的角度来看,那么改进标准库最多也只是无关紧要的。这也意味着,至少会花费一些时间和精力来改进一些你无法使用的东西,而无法改进一些你可以使用的东西。
不过,我觉得这更像是一个组织问题,而不是技术问题。Rust 对不同的人来说可能意味着不同的东西,而不一定非要某一群人做出过多的妥协。但一些紧张关系可能是不可避免的。
> 确实,这完全不会影响二进制文件大小,因为这些内容根本不会被包含进去。
这取决于语言类型。在解释型语言(包括JIT)或依赖动态链接运行时的语言(如C和C++)中,标准库不会直接包含在应用程序中,因为它是运行时的一部分。但你需要安装运行时,如果你的应用程序是唯一使用该运行时的,那么运行时的大小实际上会增加你的安装大小。
在静态链接标准库的语言中,如 go 和 rust,它绝对会影响二进制文件的大小,尽管编译器可能会使用一些方法来尝试避免包含未使用的标准库部分。
嵌入式 Rust 通常意味着没有 no_std Rust,在这种情况下,标准库和支持它的任何运行时都不会被包含在最终的二进制文件中。这也不会被外部化;no_std 代码根本无法使用 std 提供的任何功能。这大致相当于独立的 C。
你所说的对于外部运行时语言和 Go 来说是正确的,尽管 TinyGo 可用于资源受限的环境。
好吧,Rust 的标准库有三个组件,分别是 core、alloc 和 std
no_std Rust 只有核心,但这确实是一个代码库,而独立 C 并不提供这样的东西 = 独立 C stdlib 不提供任何函数,只有类型定义和其他在编译时会消失的东西。
以下两个具体的例子可以说明这一点:假设我们有一个可变的 foo,它可能是 foo: [i32; 40]; (40 个 32 位有符号整数),或者在 C 中可能是 int foo[40];。
在独立 C 中这没问题,但我们没有提供任何库代码来处理 foo,我们可以使用核心语言特性自行编写,但没有任何东西被提供。
Rust 可以轻松地执行 foo.sort_unstable();,这是一个快速的自定义就地排序,大致相当于 Rust 创建者为 Rust 编写的现代内省排序形式,由于它位于核心中,因此该代码会直接进入最终的嵌入式固件或其他地方。
现在,假设我们要对该数组执行过滤映射操作。在 C 中,你再次需要自己想出如何用 C 编写该代码,而在 Rust 中,foo impl IntoIterator,因此你可以使用所有出色的迭代器功能,算法在编译期间就会被嵌入到你的固件中。
我不希望有一个庞大的标准库。它会扼杀竞争并减缓开发速度。让库根据自身优劣自行兴衰。标准库应仅限于基础功能。
我认为这部分是正确的,但比简单地说 Rust 标准库不够完善更微妙一些。
与 go 和 c# 相比,Rust 标准库主要缺少:
– 强大的 http 库
– 序列化
但 Rust 的方法,没有运行时、没有 GC、没有反射,使得提供这些库非常困难。
在这些限制下,一些高质量的解决方案出现了,如 Tokio 和 Serde。但它们开创了一些在标准库中难以尝试的新方法。
整个异步生态系统仍然有一种 beta 版本的感觉,让人感觉像是在用另一种语言编程。过程宏通常与较长的编译时间和代码膨胀相关。
但我们所获得的,是更少的运行时错误、更高的效率以及更健壮的语言。
简而言之:权衡无处不在,将Rust与Go/C#进行比较是不公平的,因为它们是受不同约束条件限制的语言。
我认为与其他语言相比,Rust显得更加不足。
所有这些据我所知都需要第三方包:
正则表达式、日期时间、base64、参数解析、URL解析、哈希、随机数生成、UUID、JSON
我不是说这是强制性的,但我期望所有这些都应在标准库中包含,而不是在任何HTTP功能之前。
拥有这些库列表却无法更改 API 或实现,正是导致现代 C++ 采用率下降的原因(加上该语言是基于 C 的拼凑之作)。
正如之前的一些评论者所说,当你将语言设计成易于编写特定类型程序时,就会做出一些权衡,这些权衡会让你陷入这些限制,比如运行时、垃圾回收器以及嵌入在标准库中的一组API。
Rust 并非如此。作为系统程序员,我并不需要这些。Rust 是一种系统编程语言。如果 Rust 有一个臃肿的 stdlib,我不会使用它。我对它的 stdlib 非常满意。能够交换正则表达式、日期时间、参数解析和编码是一项功能。我可以选择内存密集型或 CPU 密集型的实现。我可以优化代码大小或性能,有时也可以两者都不优化或两者都优化。
如果为了迎合简单的(网络/应用程序)开发而做出妥协,那么对我来说,它就不再是一种系统编程语言了,因为我可以在 Linux 系统和嵌入式 MCU 上使用相同的异步概念。Rust 的设计实现了这一点,而其他语言(甚至 C++)的设计都做不到。
如果网络开发人员想要使用系统编程语言,那么他们就必须接受编程难度更大的语言。Kotlin 或 Swift 提供了与 Rust 类似的类型安全。
依赖膨胀确实是一个问题。轻松包含依赖也是一个因素。通过使依赖和功能更细粒化,可以解决这个问题。如果库没有提供您想要的粒度,您需要更改库/审核源代码/贡献。没有免费的午餐。
是的,我最近在为网页编写 WASM 二进制文件时,也体会到了这种方法的好处,因为二进制文件大小是我们需要优化的目标。
事实上的标准正则表达式库(非常出色!)为正确的 Unicode 操作和其他目的带来了近 2 MB 的额外内容。不过,同一位作者还制作了 regex-lite,它以相同的界面完成了我们所需的一切,而且包体积更小。这使我们能够轻松地将所需的功能放在 trait 后面,并在堆栈的不同部分选择合适的正则表达式库。
> 能够替换正则表达式、日期时间、参数解析和编码功能是一项特性
这是每个在标准库中包含这些功能的语言都具备的特性。
不一定,当标准库的其他组件依赖于它们时
同样,使用第三方库时也不一定需要。
确实。然而,你需要意识到,标准库中包含这些功能会产生巨大的偏见,使得替换它们变得困难。有多少Java开发者会使用JDBC之外的数据库API?Go语言中又有多少替代的JSON编码库?至于异步运行时,在Go中替换它们是否容易?
确实!虽然替换使用了臃肿依赖的第三方库比避免使用标准库中的内容更容易。
> 据我所知,所有这些都需要第三方包:正则表达式
Regex 不是第三方库(注意 URL 中的“rust-lang”):
https://github.com/rust-lang/regex
相对于标准库而言是第三方库。换句话说:未包含在内。
创建一个新库,命名为“标准库”,包含并重新导出所有这些库,即可。
这无法解决供应链问题。
Linux发行版就是这样构建的。发行版维护者选择要包含的库和版本,以创建应用程序的坚实基础。
这仍然无法解决供应链问题……
> 过程宏通常与编译时间过长和代码膨胀相关。
理论上它们应该减少这些问题,因为你不会创建过程宏来生成不需要的代码……对吧?与手动实现相比,使用宏能节省多少编码时间?
公平地说,我认为 Rust 在这两方面都有非常健康的选项,Serde 和 Reqwest/Hyper 已经成为事实上的标准。
Rust 还有其他需要克服的挑战,但这不是其中之一。
我认为在这一领域,Go 应该排在 C#/F# 和 Rust 之后。Go 在一些本应表现强劲的领域(如 gRPC)的工具链较为简陋,而 Go 的序列化方案与 System.Text.Json 和 Serde 相比,要痛苦得多且功能更为基础。
这种差异在正则表达式方面尤为明显,Go 配备了一个速度较慢的引擎(因为目前它无法在此领域编写足够快的代码),而 Rust 和 C# 则分别拥有顶级实现,除了 Intel Hyperscan[0]之外,其他引擎都无法与之匹敌。
[0]: https://github.com/BurntSushi/rebar?tab=readme-ov-file#summa…(注:此处未包含.NET 9或10预览版更新)
>(因为目前在这个领域无法编写足够快的代码)
我认为这不是原因。或者至少,我认为现在还无法直接得出这个结论。我认为 RE2 或 Rust regex crate 中的懒惰 DFA 完全可以移植到 Go[1] 上,并大大提高速度。事实上,这已经完成了[2], 但从未推到终点线。我猜想,这会在某些情况下使 Go 的正则表达式引擎更具竞争力。除此之外,还有大量与 Go 语言本身关系不大的字面优化可以进行。
Go 语言编写的正则表达式引擎能否因语言特性而更快或几乎同样快?可能不会。但我认为“实现质量”才是解释当前差距的更重要因素。
[1]: https://github.com/golang/go/issues/11646
[2]: https://github.com/matloob/regexp
> 在每个层次上,调用者可能只需要某个依赖项5%的功能。随着依赖树的深度增加,浪费也会随之累积。最终,你会发现一个简单的二进制文件包含了500 MiB的代码,而你实际上从未调用过这些代码,仅仅是因为你引入了那个用于格式化数字的依赖项。
我并不认为这种情况会经常发生。
作为一个在依赖树相当繁重的 Rust 库(Xilem)上工作的人,我曾多次尝试通过调整功能标志来削减依赖,但大多数情况下,这些功能都是我们所需功能的下游:Vulkan 支持、PNG 解码、unicode 整形等。
当我确实找到一个多余的依赖项时,它通常是像once_cell这样的小而无足轻重的东西。唯一例外是serde_json,我们在进行小规模重构后可以移除它(尽管我们预计大多数用户仍会依赖serde)。
我们正在考虑删除或至少分离 winit 和 wgpu 等较大的依赖项,但这需要一些重大的架构更改,而不是简单地“删除这个运行时选项,节省 500MB”那么简单。
看到多个 SSL 库被引入到从未进行过网络连接的 Rust 软件中,我感到非常“印象深刻”。
这就是为什么 a) 强大的标准库和 b) 社区对常用包的共识通常有助于至少缓解这个问题。
我认为 Python 在这方面表现不错。至少以前是这样。近年来我没有密切关注。
很多人对 Java 嗤之以鼻,但它的标准库非常稳定。它甚至(大部分)向后兼容。
你深入研究过它被引入的途径吗?
在 Rust 中没有,但在科学计算中的 Python 中见过。有人需要进行一些简单的矩阵运算,于是安装了numpy。numpy本身问题不大,但通过conda安装时会拉入MKL,目前大小为171MB(虽然我记得以前更大)。它还会拉入intel-openmp,大小为17MB。
仅仅是为了进行矩阵乘法之类操作。
> 有人需要进行一些简单的矩阵运算,于是安装了numpy
我只是不确定为了避免安装这些包而承受这些麻烦是否值得。
你想要快速的矩阵运算。为什么仅仅因为某个包占用磁盘空间更小,就要安装一个次等的包?我希望我的依赖项坚如磐石,这样我就不用去调试它们。它们不是我的核心业务——如果(当)它们“无法正常工作”,那将是一个巨大的时间黑洞。
NumPy 不是“左填充”的,所以这个论点对我来说并不充分。
由于Rust在发布构建时需要从头开始编译所有内容,因此您可以额外支付一点费用来启用链接时优化并禁用发布构建中的并行性,这样就不会编译您不使用的任何内容,也不会重复编译。此外,启用符号剥离功能后,即使包含tokio、clap、serde、nalgebra(矩阵相关功能)等库,二进制文件大小仍可控制在2-5MB之间。对我来说这仍然很大,因为我年纪大了,但如果你愿意重新编译 std 以及其他依赖项,你可以让它更小。
如果你在 Intel CPU 上进行矩阵运算,MKL 通常是你的首选。
更好的设计是让你轻松选择或热插拔你的 BLAS/LAPACK 实现。例如,AMD 平台可使用 OpenBLAS。
编辑:需明确的是,Netlib(参考实现)几乎从未是最佳选择。它设计初衷是可读性,而非针对现代 CPU 优化。
我认为 BLIS 才是理想选择。它属于真正的开源项目,且不依赖 Intel 平台。
符号筛选和死代码删除在现代编译器和链接器中已经很常见了,rust 也可以做到:https://github.com/johnthagen/min-sized-rust
其他人也提出了类似的观点,但树摇动、符号筛选以及任何在代码已分发和/或编译后再去除死代码的操作,在我看来都为时已晚。这只是对问题的权宜之计。虽然今天这确实是一个有用且务实的权宜之计,但从根本上说,我对我们必须花时间编译代码,然后再花更多时间分析并将其移除感到困扰。
我对依赖膨胀问题的部分担忧在于,我们目前需要花费大量精力来下载、分发、编译、检查语法、类型检查等处理数千行我们不需要或不想要的代码。我希望软件能够让我只构建所需的代码,永远不需要触碰那些不需要的部分。
> 其他人也提出了类似的观点,但树摇动、符号清除以及任何在代码已经分发和/或编译后删除死代码的方法都为时已晚,我认为。
为什么,从原则上讲,相同的算法不能在分发前工作?
说到这一点,看看Python生态系统中的`auditwheel`工具。
如其他人 elsewhere 所指出的,这仅能移除静态依赖项。若代码路径依赖于动态函数参数,静态分析无法捕获此类情况。
例如,你有一个函数根据某些输出格式参数调用 XML、PDF 或 JSON 输出函数。这是三条非常不同的路径和包含,但如果你不知道该参数在运行时可能取哪些值,你就必须包含所有三条路径,即使实际上只使用了 XML(例如)。
或者可能存在分析范围之外的高级原因,即使你实现了动态分析。例如,在图形用户界面(GUI)中,某些功能可能仅对特定角色用户可见,但如果只有一个应用程序,所有内容都必须打包在一起。类似的情景在各种软件中都可能出现,例如支持多种输入和输出场景的分析应用程序。这与第一个示例类似,只是参数从内部变为外部数据,而外部数据无法进行分析,因为它只有在软件实际使用时才会被知晓。
情况并没有你描述的那么糟糕。现代编译器也可以进行去虚拟化。随之而来的静态调用可以成为整个程序中树摇动(tree shaking)的输入。虽然我们无法在一般情况下解决这个问题,但特定情况下仍有希望。
很久以前,我曾将所有库(Java/C++/Python)打包到一个单一仓库中,并将构建流程集成到项目构建文件中,这样任何人都可以使用自己喜欢的编译器选项重建整个应用程序栈。
这种方法效果很好,但需要细致操作,而且它迫使你以一种与在依赖文件中添加一行代码不同的方式与依赖项交互。
Cargo的一个优点是它会将所有代码一起构建,这意味着你可以为所有内容传递一组统一的标志。始终将所有内容作为整体构建的特性有许多缺点,其中许多已在其他地方提及,但无法按你想要的方式构建依赖项的具体问题并非其中之一。
这是谷歌单仓库(monorepo)中的默认做法。
在看到好处之前,这感觉像是一种折磨,而相反的情况……多个版本和庞大的传递依赖链的混乱……更是令人痛苦。
我更愿意在以这种方式管理依赖项的团队中工作。但这样的团队很难找到。
我从未见过有哪个地方能像谷歌那样做到这一点。有这样的地方吗?这只有在你有单一产品或是一家大型公司时才可行,因为这样做成本非常高。
能够深入修改依赖项并重新编译整个系统,这简直就是魔法。我不知道自己是否还能回到过去。
这与我们在 QEMU 的 Rust 实验中对外部 crates 所做的工作相同。每个新的依赖项都是手动添加到构建中的。
[已删除]
确实如此,或者说在我那十年里确实如此。我参与了Google3(在广告、Google WiFi、光纤和其他项目上)、Chromium/Chromecast、光纤和Stadia的开发,而这些仓库——所有不同的仓库——都使用了vendored依赖项。
对于任何非玩具项目,我都会这样做。
对于某些项目,可能只需依赖Debian稳定版或其他LTS发行版提供的内容即可。
Maven 是导致依赖地狱的始作俑者。(Ant 也是,但它更难盲目地将东西包含进去)
现在的年轻人已经不知道如何这样做了……
然而,即使在 Java 等语言流行了 20 多年后,Maven 仓库仍然没有那么臃肿。
相比之下,在 Rust 中,我之前使用 protobuf 库的经验是,不是只有 1 个,而是有 3 个不同的库可供选择,其中一个不支持服务,另一个不支持我们必须支持的语法,第三个没有维护。因此,在 3 个选择中,没有一个能用。
相比之下,在 Maven 中,只有一个官方支持的选择,它运行良好且维护良好。
更多时间意味着更多整合。
不,从来没有多个非官方库,其中一个最终赢得了流行度竞赛。一直只有一个官方库。添加项目到那里有一些障碍,所以这可能有所帮助。
这一点在Java的主要竞争对手.Net中表现得更为明显。他们会观察Java生态系统中哪种方法胜出,然后全力支持。例如,有多个ORM工具在竞争,微软最终采用了最受欢迎的一个。因此,在那里的选择更加明确,且得到良好支持和维护。
> 微软采用了最受欢迎的一个
这仍然是一种整合,也需要时间。
即使在 Rust 中,像 hashbrown 或 parkinglot 这样的 crates 也基本上被纳入了标准库。
同意,我思考了更多例子之后。谢谢,不知道为什么其他人要投反对票。
除了整合这一点,我仍然认为“进入门槛”这一点仍然成立——如果发布一个库需要更多努力,那么它的作者可能已经更加投入。
这在不同依赖树的各个部分开始以略微不同的标志/设置拉取相同的 Foo 之前都工作得很好。有时是因为错误的原因,有时是因为正确的原因,然后就成了另一种“乐趣”。有时构建系统会帮助你,有时你只能靠自己。像C++这样的原生语言会带来一种特殊的“乐趣”,叫做ODR违规……
>在每个层次上,调用者可能只需要某个依赖项5%的功能。随着依赖树的深度增加,浪费也随之累积。最终,你可能会发现自己的简单二进制文件包含了500 MiB从未实际调用的代码,而你所做的只是引入了一个用于格式化数字的依赖项。
那么,编译器为何不移除未使用的代码?
这里的“依赖项”指的是编译器无法假设你永远不会使用的更高层次的组件。
例如,你知道你永远不会使用解析库中某个主函数的某个参数设置为“XML”,因为你确信你的领域中不使用XML(例如,项目有明确的约束条件规定XML不在范围之内)。
不幸的是,库中处理 XML 的代码占了 95%,你无法告诉编译器“我不会需要这个,我保证永远不会调用该函数并设置参数为 XML”。
为什么编译器无法检测到它不会被使用?树摇动(Tree Shaking)在 JavaScript 编译器中已实现得相当完善,而该生态系统正广泛遭受此类问题困扰。应该可以构建依赖关系图并分析哪些函数可能最终进入作用域。毕竟,对于闭包,同样的分析已经完成。
一个更现实的例子:类似于printf或scanf的函数。它可以接受多种类型的对象作为参数。它从环境中获取计算机的区域设置,并进行区域设置相关的数字和日期格式化,还支持从操作系统读取的各种时区。
并且你总是将其运行在使用特定区域设置的数据中心中,仅使用UTC时区,且仅支持少量简单类型。但所有这些信息只能在运行时得知,除非编译器足够强大,否则类型信息可能无法提前确定。
正如帖子中深入讨论的那样,可能会发生类似的情况
doc_format = get_user_input() parsed_doc = foolib.parse(doc_format)
作为实现者,你可能知道用户绝不会输入 XML,因此 doc_format 不能是 ‘xml’(你甚至可能添加一些错误处理,如果用户输入了这个),但如何将这一点传达给编译器?
这被称为糟糕的库设计。与其使用全局变量,不如创建一个实例化的解析器,该解析器接受特定的编解码器。
这无关紧要,如果格式来自运行时,编译器就无法知晓。
你所说的“树摇动”在编译器中更常见的名称是“死代码消除”,这是任何生产编译器都会实现的基本优化之一。
大量代码可能在罕用或未文档化的代码路径中被执行(例如,当DEBUG环境变量为1或插件启用但未实际使用时),因此不会被编译器摇出。
你为什么认为大量代码隐藏在dbg环境变量背后,而不是例如dbg构建中?
许多库都有“冗长”的日志记录标志,其数量远超预期。我记得许多需要 `winston` 的 NPM 库都是运行时可配置的。或者需要 Log4J 的 Java 库。使用 Rust 时,这很难记住,因为如今的一切似乎都把厨房水槽都搬出来了……
甚至超越“调试”范畴,许多库提供的功能对用户而言简直是多余的。
最近两个著名的例子是Heartbleed和Log4shell。
> 只需输入`import foolib`,然后调用`foolib.do_thing()`即可开始运行。
这实际上绕过了链接器。
过去,创建库时,每个函数都会放在独立的编译单元中,生成一个“.o”文件,然后将它们打包到一个“.a”存档中。当其他人编译他们的代码时,如果需要 do_thing() 函数,链接器会发现它未被满足,并从 foolib.a 存档中提取出来。对于命名空间,你可能会调用函数 foolib_do_thing() 等。
然而,使用“神对象”的面向对象编程是一种弊端。我们通过一个顶级对象如“foolib”进入,该对象包含指向所有成员函数(如do_thing()、do_this()、do_that())的指针,然后其他人的代码中唯一引用的就是“foolib”……而“foolib”会引入库中的所有其他内容。
链接器无法判断,例如,foolib是否仅需引用do_that()来初始化其成员,而其他人从未需要它,因此可以消除它,或者foolib或用户代码是否会以某种方式需要它。
例如,Go 和 Rust 鼓励将单个包/模组的所有内容都放在同一个文件中。
我可以说,至少对于 Go 而言,它具有出色的死代码消除功能。如果你不调用它,它就会被删除。即使你在代码中拥有 const feature_flag = false 和 if feature_flag { foobar() },它也会消除 foobar()。
foolib 是库的名称,不是对象。
它碰巧也是一个对象,但这是因为 Python 是动态语言,库是对象。C++ 的等价形式是 foolib::do_thing(); 其中 foolib 不是对象。
例如,Go 和 Rust 鼓励将单个包/模组的所有内容放在同一个文件中。
澄清:Go 允许使用非常简单的多文件。我非常喜欢这个功能,因为它允许将原本连贯的模块分割成逻辑部分。
此外:我从未见过 Rust 鼓励过这种做法。包含 mod.rs 和任意数量文件的模块目录完全没问题。
我可能对这一点有误解,因为我已经很久没有做过重要的 Rust 工作了。据我所知,在 Rust 中不可能只依赖模块的一部分,对吗?(至少没有外部构建系统的话)
例如,你无法将一个模块拆分为包含Foo的foo.rs和包含Bar的bar.rs,两者均属于模块'mymod',同时实现use mymod::Bar且foo.rs从未被构建/链接。
我的观点是,包/模块的粒度鼓励粗粒度依赖,而我认为这是个问题。
你可以使用功能标志来启用库的某些部分。
> 在 Rust 中无法只依赖模块的一部分,对吗?
是的,你可以使用类似于 C 中的 `#if` 的功能标志。
但这也不是一个真正必要的特性,因为死代码消除会移除所有未使用的代码函数、类型等。这些内容都不会出现在生成的二进制文件中。
是的,同样,在您说“mod foo”并创建一个名为 foo.rs 的文件后,Rust 完全没问题,如果您还创建了一个 foo/ 目录,并将 foo/whatever.rs 和 foo/something_else.rs 放在该目录中,那么它们都是 foo 模块的一部分。
从历史上看,Rust 希望将 foo.rs 重命名为 foo/mod.rs,但这种做法已经不再符合惯例,尽管如果你这样做,它当然仍然有效。
对此进行扩展:
在 Rust 中,crates 在语义上是一个编译单元(在 C 中,它被过度简化为一个 .h/.c 对,实际上 rustc 会尝试将其拆分为多个单元,以加快构建速度)。
我指出这一点是因为,许多“将模块拆分到多个文件”的情况源于这样一种情形:一个文件是一个编译单元,因此你需要一种方法在某些情况下将它拆分(为了组织)而不拆分(为了编译)。
不仅仅是多个文件,还有多个目录。一个版本化的依赖项(模块)通常由数十个目录(包)和数十到数百个文件组成。只有来自其他语言的新手才会不必要地创建过多的 go.mod 文件。
最终,你会发现你的简单二进制文件有 500 MiB 的代码,而你实际上从未调用过这些代码。
面对这些夸张的描述,人们很难认真对待这些对话。没有人会因为添加几个简单的依赖项而制作出 500MB 甚至 50MB 的 Rust 二进制文件。
你也不会得到一大堆在 Rust 中从未被调用的代码。
即使我的 Rust 二进制文件最终达到 10MB 而不是 1MB,现在也不再重要了。要么是部署在服务器平台上,这种数据量微不足道,要么是嵌入式设备,相比当今设备上其他内容,多出几兆字节并不算什么。
对于真正受空间限制的系统,有 no-std 以及一个虽小但独立的包生态系统专门针对这类场景。
尽管人们对此持悲观态度,但在 Rust 中,我从未遇到过一些人担心的过度膨胀问题,即使是在大量使用依赖项的项目中也是如此。
每次阅读这些帖子时,我都觉得这些对话被“非我发明”和怀旧的人所劫持了。像这样的评论,怀念购买付费库然后将它们拆分的日子,真的强化了这种想法。在这个评论区,还有很多人对异步编程甚至 Rust 本身抱有通常的蔑视态度。与此同时,似乎还有另一群 Rust 开发者,他们只是继续工作,不关心关于函数着色或重写库以减少几百 KB 二进制文件大小的无休止讨论。
我同意关于臃肿的说法,考虑到我的 Rust 项目通常除了一个几兆的 libc 之外,不会使用任何共享库,而一个二进制文件包括数百个依赖项的 crates(其中大部分是 rustc 或 cargo 本身的一部分),似乎并不算太糟糕。我理解异步的概念。它只是不适合我大多数需求。除非你处于需要更快等待(通常是连接)的情况,否则线程比异步更适合尝试更快地计算。
这个想法已经在 .NET 中实现,通过 Trimming 和现在的前置编译(AOT)。也许其他语言可以向 .NET 学习?
https://learn.microsoft.com/en-us/dotnet/core/deploying/trim…
https://learn.microsoft.com/en-us/dotnet/core/deploying/nati…
死代码消除是一个非常古老的话题
它一直被不断重新发明,比如在 dotnet 中用“修剪”,在 JS 中用“树摇动”。
C/C++ 编译器在 dot net 出现之前就已经在做这件事了,rust 自 1.0 版本发布以来也在做这件事(因为它是 LLVM 做的 😉 )。
它之所以被不断重新发明,是因为虽然在静态编译语言中这通常相当直观,但在动态语言中却并非如此,因为确定哪些代码实际上未被使用(对于精细的代码消除)或至少不可靠(修剪子模块)。对于脚本语言来说情况更糟。
这也带来了一个非标准应用领域,即在一次构建过程中构建 .dll/.so,然后在另一次构建过程中使用它们。在这种情况下,需要额外的工具来修剪动态链接库。但幸运的是,这并不是 Rust 中常见的问题。
一般来说,Rust 中大多数代码规模问题并非由依赖项的代码行数(LOC)过多引起,而是由于过度使用独占式操作所致。依赖项中大量代码行数的问题更多是供应链信任和审查能力的问题,而非其他因素。
> 它之所以被不断重新发明,是因为在静态编译语言中,这通常相当直观,但在动态语言中则不然,因为确定哪些代码实际上未被使用(用于精细的代码消除)或至少不可靠(修剪子模块)。对于脚本语言来说情况更糟。
在我看来,从严格意义上讲,消除死代码的问题对于使用某种形式的 eval() 的代码可能是不可能的。例如,你可以使用 eval(decrypt(<加密代码>, 密钥)),其中密钥由用户提供(或以其他方式混淆);或者简单地使用 eval(<外部提供的代码>);这两种情况都可能调用之前被视为死代码的代码。尽管似乎可以排除此类情况。没有 eval(),部分问题似乎非常简单,比如未使用的函数可以直接删除!
当然,还存在更经典的障碍,如停机问题,这在一般情况下表明,判断一段代码是否被执行是不可决定的。
(当然,我们仍然可以编写保守的决策,只删除一组易于证明的死代码——停机问题确实是可以决定的,如果你是保守的,并且接受“我不知道”以及“停止”/“不停止” 🙂 )
是的,即使没有Eval,JS中也有大量反射机制在技术上会被死代码消除(以及其他变换,如压缩)破坏,但大多数JS工具会做出一些相当合理的假设,即你不会使用这些功能。例如,压缩工具假设你不会依赖特定的Function.name属性被保留。打包工具也假设你不会使用eval来调用死代码。
反射代码是邪恶的。
> 通常,Rust 中大多数代码大小问题并不是由依赖项的 LOC 过大造成的,而是由过度使用垄断
*单态化造成的,以免有人感到困惑。
而我原本以为 Rust 已经消除了联合体。
这些是在编译时完成的。许多语言(包括本文所讨论的 Rust)也在编译时删除了未使用的符号。
你回复的评论是在说,如果不需要依赖项,那么在编译之前就完全不要引入它们。
我认为库本身不是问题,但添加新依赖后我们缺乏可见性。要么花时间调查,要么直接添加后忽略问题(这正是使用小型库的初衷)。
应该很容易构建和部署支持性能分析的构建(PGO/BOLT),并获得关于每个包花费的时间/指令的良好反馈,以及衡量每个库在构建时被冷启动或丢弃的比例。
我同意我不喜欢将库视为问题。但它们似乎是现代开发地狱中最容易被指责的领域。这有点疯狂。
我需要指出,这不仅仅是PGO/BOLT风格的优化。实际上,情况并非如此,这有点奇怪。
相反,问题在于稳定性。这里所说的稳定性是指“一个不会移动并导致你摔倒的基础”。想象一下,如果人们建造一栋房子,每个房间都有不同的底层结构。这在很大程度上似乎是我们构建软件时采用的通用方法。其核心思想是,你可以将一个房间与其他房间隔离,无需关心其中发生的事情。
当我们用于评估某物安全性的指标主要鼓励对依赖项采取行动时,这种情况同样令人沮丧。人们必须添加依赖项,否则会认为该依赖项已被放弃且不可用。
需要注意的是,这并非软件独有的问题。硬件在多年间也会经历重大变化。当然,硬件有明显的限制,这会减缓其变化速度。
> 实际上,问题在于稳定性。这里的“稳定性”指的是“一个不会移动并导致你摔倒的基础”。想象一下,如果人们建造一栋房子,每个房间都有不同的底层结构。这在很大程度上似乎是我们构建软件时采用的通用方法。其核心思想是,你可以将一个房间与其他房间隔离,无需关心其中发生的事情。
我不确定这里的问题是什么。
你是想固定依赖项以确保它们没有变化吗?通常我希望更新依赖项来修复其中的 bug。
您是通过代码审查还是测试来信任它们?我认为这没有捷径可走。您不应信任任何库,无论其是否经过修改,因为旧漏洞和新漏洞都可能导致双方都面临风险。在审查他人代码时,我认为Rust通过明确标记和隔离不安全代码有所帮助,但仅凭内存安全并不足够,因为逻辑错误可能毁掉您的业务。如果错误或崩溃会造成影响,您就无法避免测试。
稳定性在于您不希望引入一个在未来十年内会强制您进行迁移的依赖项。或者更长时间。您也不希望引入一个会在常见路径中启用广泛功能的依赖项。
示例:Google的Guava用于迁移部门。Apache Commons是一个很好的反面教材,展示了如何不让用户感到痛苦。
对于广泛功能,Log4j引入了一些相当严重的安全问题。
> 我需要指出,这不仅仅是PGO/BOLT风格的优化。实际上,情况并非如此,这很奇怪。
确实,无需删除可证明无法到达的代码。但我一直在思考如何衡量某个库是否真正发挥了其非零价值,以及其中消耗了多少 CPU 资源。
如果某个库在处理你认为可以更快完成的任务时耗时过长,可能需要替换它,或用简单实现替换(例如该库关注你未遇到或可避免的边界情况)。
完全同意这可能非常主观。有些事情本身就很难,无法明确界定什么是“太大”。
我认为PGO/BOLT不相关的主要原因是,我看到有人使用库来实现诸如为系统添加重试等功能。我并不认为这一定是糟糕的主意,但当与更大规模的“重试加其他功能”库结合时,可能会带来问题。
当然,当开发者频繁重新实现复杂数据结构时,情况也可能变糟。必须进行某种权衡计算。我认为我们尚未完全理清这一点。
> 这是一个糟糕的想法…
这是一个糟糕的想法,因为你试图在链接时重新发明分段 + `–gc-sections`,而 rust(本文所讨论的主题)已经默认实现了这一点。
这篇文章是关于 Rust 的,但我是在评论依赖关系的一般问题。
像 –gc-sections 这样的东西感觉像是一个创可贴,一个非常实用且有用的创可贴,但毕竟还是一个创可贴。你正在构建一些你不需要的东西,然后有选择地抛弃部分内容(或有选择地保留部分内容)。
依我之见,这一切都归结于粒度问题。文本源文件的粒度、库的分发单元粒度。这些都导致了依赖项无序膨胀的难题。
我没有完美的解决方案,只是基于依赖项失控增长时出现的可怕现象,对这一普遍问题进行的观察。
一个常被忽视的考虑是,浪费会以指数级增长!
如果每个“包抽象”层的利用率仅为50%,那么每个层都会使总大小比实际应用所需的大小增加2倍。
三层——包引入其他包,而这些包又引入自己的依赖项——已经导致88%的冗余!(或仅12%的有用代码)
一个例子是新的Windows 11计算器,它可能需要几秒钟才能启动,因为它加载了像Windows 10 Hello for Business账户恢复助手库这样的垃圾!
为什么?因为它包含货币转换功能,该功能使用HTTP库,该库支持企业级Web代理,需要身份验证,需要WH4B账户支持,可能被锁定,需要恢复助手界面……
……在一个计算器中。你必须先成功登录才能启动它,而这显然不是启动账户恢复工作流的“合适位置”。
但是……你明白……将这些功能打包并通过代码中的一行指令包含进来,确实更简单。
如果我们有一个系统,可以使用一套标准工具来管理此类共享资源访问,那该多好。
据我所知,LTO从二进制大小的角度完全解决了这个问题。它会优化掉所有未使用的部分。不过从构建时间的角度来看,你仍然可能会受到影响。
“完全解决”有点夸张。想象一个类似 curl 的库,允许你通过 URL 发起请求。你可能只使用 HTTP URL,但其他协议(如 HTTPS、FTP、Gopher)的代码也需要编译进去。
这是一个极端的例子,但类似情况在较小规模上经常发生。可选功能并不总能静态移除。
这仅在涉及动态调度且链接器无法追踪调用时适用。对于直接调用和泛型(Rust 代码通常更倾向于使用泛型而不是动态特性),LTO 会进行大量修剪。
    let uri = get_uri_from_stdin();
    networking_library::make_request(uri);
编译器应该如何进行优化?
let uri: Uri<HTTP> = get_uri_from_stdin().parse()?;
如果库以模块化方式实现,通常会这样做。`HTTP`可能通过函数后续调用推断出来。
如果用户通过标准输入传递包含 ftp:// 或甚至 https:// 的 URL,会发生什么?还是说这是一个仅支持 HTTP 的库?
这取决于具体需求,在这种情况下会失败(因包含?),并报告这不是有效的HTTP URI。这适用于支持多种协议解析的通用解析库,每种协议都有各自的解析规则。
如果你想混合协议,就需要能够处理所有协议;你可以通过相同的泛型遍历所有变体进行测试,或者直接接受需要一个完整的URI解析器并放弃泛型。
如果你想混合协议,就应该直接混合协议。
let uri: Uri<FTP or HTTP or HTTPS> = parse_uri(get_uri_from_stdin()) or fail;
你看,Rust 中的特性系统实际上迫使你在最核心的层面上发现你的需求。这不是一个错误,而是一个特性。如果你需要 HTTPS,那么你当然需要包含执行 HTTPS 的代码。那么 LTO 不应移除它。
如果你的库无法解析 FTP,那么你需要启用该功能、添加该功能,或者使用其他库。
不,这行不通。请求的类型需要是动态的,因为用户可以传入任何 URI。
那么他们也可以传递一个错误的 URI。你仍然需要某种方式来处理你不接受的那些。
我猜这取决于实现方式。如果你是通过一个动态选择协议的 API 调用,那么我猜它就无法被移除。
Rust 确实有针对此类可选功能的标志系统。它并不完美,但对于类似 curl 协议后端的东西来说,它非常有效。
这是复杂且繁琐的协议和标准带来的后果,这些协议和标准需要对不同的传输和向后兼容性提供大量支持。如果你想与全世界进行互操作,这是很难避免的。
是的,这不是代码大小的问题,而是供应链安全/可审查性的问题。
这种比较也不总是公平的,如果你在计算 LOC 时包含 Tokio,那么你肯定也会在计算 Node 时包含 V8 的 LOC,或者在计算 Java 项目时包含 JRE(但不包括 JDK)等。
而且,归谬法而言,你或许也需要统计Linux中的2700万行代码。(或Windows、macOS或其他任何作为你程序基本“依赖项”的操作系统中的代码行数。)
或者你可以使用APE,这样所有这些代码行数都会消失。APE二进制文件可以直接启动硬件,并在三大操作系统上从同一文件运行。
这显然比Java更好,因为Java中由于反射机制,LTO根本无法实现。更关键的问题是,究竟哪些代码会被实际编译,以便你知道需要审计的内容。也就是说,无需反编译二进制文件。也许调试信息能提供帮助?
不仅可行,商业AOT编译器如Aonix、Excelsior JET、PTC、Aicas已支持该功能数十年。
Android平台也实现了该功能,且在GraalVM和OpenJ9中可免费使用。
这些实现均通过打破兼容性来实现。
不,它们没有,PTC、Aicas、GraalVM和OpenJ9支持反射。
其他已不再重要,因为它们已退出市场。
在反射存在的情况下无法进行LTO编码。你可以进行AOT编译,但始终会存在一个“冷路径”,其中需要解释剩余部分。
然而它确实可行,得益于额外的元数据,无论是动态编译器在内存中实现(通过陷阱机制丢弃执行路径并在需要时重新计算),还是AOT编译时使用类似PGO的元数据。
而且除非被证明是错误的,否则我们总是错误的,
https://www.graalvm.org/jdk21/reference-manual/native-image/…
https://www.graalvm.org/latest/reference-manual/native-image…
你明白当前讨论的主题并不是要将支持陷阱所需的所有代码四处传播吧?
在 Go 语言中,符号表包含足够的信息来确定这一点。这就是为什么 https://pkg.go.dev/golang.org/x/vuln/cmd/govulncheck 能够将漏洞限制在代码中实际可达的部分。
符号表可能包含反射元数据,但它肯定无法识别其中哪些部分会被使用。
这是可能的,近年来生态系统已通过原生映像元数据对此提供了更好的支持。许多库现在都包含元数据,用于指示通过反射访问的内容,而静态 DCE 优化也在不断改进。它可以做的事情包括传播常量以检测更多无用代码。即使是大型服务器框架如Micronaut或Spring Native现在也支持它。
另一个好处是字节码易于修改,因此如果你有一个库包含一些你知道不需要的功能,你可以直接移除它们并节省资源。
Java难道没有类似C#的代码精简功能吗?我知道它不会移除所有内容,但至少可以精简很多东西。
是的,jlink、Code Guard、Android上的R8/D8,如果你想在字节码级别操作,再加上所有商业AOT编译器和免费版本,都在二进制级别提供类似功能。
本帖中到处都在讨论LTO是否“完全”解决了这个问题,但为什么一开始就需要LTO呢?在C++中,跨翻译单元消除死代码传统上是通过类似-ffunction-sections的选项实现的,同时也可以通过将函数实现移至头文件(内联)来实现。
Clang还支持通过-fvirtual-function-elimination实现虚拟函数消除,据我所知,这目前需要完整的LTO [0])。通常,虚拟函数无法被移除,因为虚函数表(vtable)引用了它们。这对于减少我们自身抽象带来的冗余非常有帮助。
[0] https://clang.llvm.org/docs/ClangCommandLineReference.html#c…
> 据我所知,LTO 从二进制大小的角度完全解决了这个问题。
我不会说完全解决。人们有时仍然难以让它正常工作。
近期例子:(Go Qt绑定)
https://github.com/mappu/miqt/issues/147
LTO只能解决部分问题,但依我之见,这更像是将问题推迟解决。
我常用的比喻是:准备一顿丰盛的晚餐,最后却只留下你想要的那道配菜。如果你只想做配菜,就应该能只做配菜。
我更倾向于将它视为拥有一个庞大的食材库,只需根据具体餐点需求使用所需的食材。
然后,另一群沙发程序员会因为你使用了小依赖而骂你。
我根本不听。事情应该简单。Rust 很简单。不要想太多。
其中一些沙发程序员还记得 npm 事件和 leftpad.js 破坏了互联网的一部分。
当然,不要想太多。但想得太少也会造成严重的问题。
LTO 已经取得了很大的进展,但例如,它无法帮助消除未使用的枚举(和相关的代码路径)。据我记忆,这是在每个 crates 的 MIR 优化中发生的,这比 LTO 的 llvm 优化更早。
Go 的实际行为似乎比你所描述的更接近理想场景。虽然它更复杂,但两者都是正确的。在 Go 中,模块是一组包的集合。当你获取一个模块时,整个模块会被拉取到主机上,但当你只将使用的包(以及我认为仅从该包使用的符号,但不确定)作为依赖项添加到模块时,这些包会被作为依赖项添加到你的模块中。
_> 在某些情况下,语言会使情况变得更糟。例如,Go 和 Rust 鼓励将单个包/模块的所有内容都放在同一个文件中。
什么?我对 Go 不太了解,但 Rust 肯定不是这样的。Rust 通过 Cargo 的 crate 功能将 API 分割,对精细导入提供了很好的支持。
有一种名为 Unison 的有趣语言,它实现了这一想法的一部分(尽管动机略有不同)
函数通过 AST 结构定义,并以内容为地址。每个函数随后通过哈希值在全局注册表中进行键值映射,您可以从中提取以供重用。
> 我能想到的解决这个问题的长期方案是使用超细粒度的符号和依赖关系。每个函数、类型和其他顶级语言构造都需要声明其运行所需的资源集合(其他函数、符号、类型等)。当你依赖某个符号时,它可以按需构建所需的精确符号图,并丢弃给定库中的其他部分。最终,你将获得实现所需功能的最小代码集。
或者,你可以使用超细粒度的模块,并依赖现有的树摇动系统……?
如果你仔细想想,每个函数实际上通过使用其他函数来声明其依赖关系。你知道一个函数是否需要另一个函数,因为它会调用该函数。那么你到底在问什么?要求程序员在每个函数上方注释中插入依赖函数列表?编译器可以为你做到这一点。编译器可以帮助你提升一个层次,插入函数所属模块的名称?
我理解现有树摇动算法(死代码消除等)正是基于此原理工作。但 Python 过于动态,无法仅通过阅读源代码提前确定使用情况。eval 和 exec 存在;几乎所有类型的命名空间都以字典或具有属性的对象形式反映,且大多数是可变的;而导入系统纯粹在运行时工作,并拥有令人眼花缭乱的钩子。
> 我能想到的长期解决此问题的唯一真正方案是超精细粒度的符号和依赖关系。每个函数、类型及其他顶级语言构造都需要声明其运行所需的资源集合(其他函数、符号、类型等)。当依赖于某个符号时,系统可按需构建其精确的符号图,并为给定库丢弃其余部分。
这不就是JS模块系统吗?这就是我们通过树摇动来缩小包大小的方式。
正如许多人所提到的,“树摇动”只是死代码消除的重新包装版本,这是一个非常古老的想法。我认为JS并没有做OP所建议的事情,你肯定不会声明每个函数的精确依赖关系。
> 在每个层次上,调用者可能只需要某个依赖项5%的功能。
我认为这在难以添加依赖项的生态系统中是一个更大的问题。
当添加依赖项困难时,你会得到一些包含大量不需要功能的大型库,因此你只需要添加几个依赖项。另一方面,如果依赖管理容易,你最终会得到很多只做一件事的小包。
已故的乔·阿姆斯特朗有一个关于开源的想法,即它应该只是我们发布的函数集合。这将解决这个问题。
另一方面,这还取决于你构建的架构。如果你有一个本地优先的厚客户端,初始安装的 800 MB 并不重要,因为安装后你可以在一个由你严格控制的点对点网络堆栈上进行通信,但你在 UI 层会承担大量的依赖项,以提供例如无限协作画布基于协作和绘图的功能。
小型库确实有助于精简代码,但 npm 中的 isEven、isOdd 和 leftpad 真的是最优解吗?——我更倾向于由团队维护的大型库,这样更容易保证持续性且不同模块能协同工作。
我只是一个大学生,如果这个问题很愚蠢,请原谅。我们知道 Rust 编译器可以检测到未使用的代码、变量、函数等,所有语言的 IDE 也可以做到这一点,那么为什么我们不直接删除这些部分呢?未使用的代码不会被编译。
主要是因为在某些库中,部分代码会在运行时被激活。
很多冗余代码来自可以通过标志、将变量设置为 true 的方法、环境变量或配置文件激活的功能。
谈到 LTO 时,我们不期望它移除在运行时使用的代码。此类代码按定义并非死代码。
如果你想禁用某些运行时功能,你可以通过功能标志来实现。
当然,但我指的是那些未启用LTO的库中的冗余代码。如果没有功能标志和插件功能,LTO就无法发挥作用。有很多非核心库就是这样。
同意这是一个问题,但我无法提出其他解决方案,除了你提到的通过值引用函数(简而言之,对它们进行哈希处理)的方法,这与Unison(?)提出的方案类似。
但我认为目前应对这一问题的最佳策略是极度重视系统依赖关系的保护。你需要避免导入那些包含10行函数的随机库。你应该直接将该函数复制到自己的代码库中。不要随意拼凑各种工具。以可维护且面向未来的方式开发库是例外而非常态。一些生态系统在这方面做得不错,但大多数都失败了。Ruby和JS可能是最糟糕的。尝试将一个Rails 4应用程序升级到现代工具链。
所以……要对你的依赖项极为保护。仅仅安装一个简单的库就很容易积累技术债务。库使用库。这个问题会迅速变得复杂。
初级工程师似乎会随意将包添加到我们的核心仓库中,我不得不立即介入并询问为什么需要这个?你真的想因为在开发环境的命令行工具中需要以表格形式打印对象列表,而有一天导致生产环境崩溃吗?
> 在 80 年代,功能库的概念是需要付费购买的,并且需要费力地将部分功能整合到受限于磁盘空间的环境中(将其放入软盘)。你可能把这个库拆开,提取出你需要的部分,然后将它们整合到你的构建中,以尽可能地减小体积。
如果要说的话,20 世纪 80 年代是完全可重用、单独开发的软件组件的概念首次成为现实的时候,Objective-C 之类的语言就是例证。事实上,这种普遍的软件组件现在已被广泛采用作为系统编程语言的一部分,这是 Rust 的一项重大成就。
你说的80年代和我的不同。在工作站和Unix大型机上,Smalltalk和Objective C这类“猛兽”横行。而在家用电脑上,一个不属于ROM的可重定位驱动程序还是一种罕见的创新。
是的,90年代更准确。当时COM控件和控件库市场巨大,而很多Objective C相关技术都附带高昂成本。
这是实现代码复用的最佳方式,我完全支持。在必要时进行优化,并利用经过测试的代码更快地构建系统。
大小问题和代码膨胀可以通过树摇动(tree shaking)解决,这与包生态系统的粒度无关。对于服务器端来说,这并不重要(至少人们不在乎)。在客户端,大多数生态系统都有实现方法。Dart 支持,Android 通过 ProGuard 实现。
依赖项更紧迫的问题是供应链风险,包括安全风险。这就是为什么大型组织在使用开源软件时会有审批流程。不幸的是,JS和Go等新出现的开源项目似乎都患有“我不在乎从互联网上拉取什么垃圾代码”的症候群。
不幸的是,只要你的1000个函数来自NPM上的1000个作者,粒度就无法解决这个问题。
我记不起上次看到有人如此明确地表明他们对库、编译器和链接器的工作原理一无所知是什么时候了。
死代码消除意味着二进制文件大小的膨胀不会因依赖关系的膨胀而增加。因此,对于像 Rust 这样的编译型语言来说,这一点几乎无效。
死代码消除与停机问题完全相同。它最多只能是近似的(而且希望是保守的!)。
不,静态分派语言中的死代码消除不等同于停机问题。
我很好奇 Rust 是否也有这个问题。我在 npm 领域注意到的问题是,许多开发人员没有品味。例如,有一个名为 glob 的通配符库。你可能会认为它只是一个执行通配符操作的函数,但事实并非如此,作者认为它还应该是一个独立的命令行可执行文件,因此加入了一个庞大的命令行选项解析器。他们本可以轻松地创建一个独立的命令行工具,其中包含一个进行通配符匹配的库,但没有,这是 npm 中常见且糟糕的模式。我估计至少 25% 或更多的“你的依赖项已过时”消息都与这些库中命令行工具的参数解析有关。这只是一个例子。
此外,设计上也存在争议。一个“glob”库是否应该读取文件系统并返回文件名,还是仅仅告知字符串是否匹配glob模式并由用户自行处理剩余操作?我认为后者是更好的设计,即最简单的方式。这意味着更少的依赖项和更大的灵活性。我无需通过修改或添加选项来使用自己的文件系统(例如用于测试)。我可以将其与变更监控系统等结合使用…
而且,我确信有大量开发者更喜欢 glob 是一个“包办一切”的库,而非“只做一件事”的库,因为这样能获得更多“互联网积分”——你的库对使用者技术要求越低,你获得的积分就越多。
我无法想象在Rust世界中会有什么不同,除了可能涉及可执行文件的部分。开发者实在太多了,而我们所有人,包括我自己在内,并不总是做出最佳选择。
> ‘glob’ 库是否应该实际读取文件系统并返回文件名
这些功能命名的依据是 POSIX 的 glob 函数,它会遍历文件系统并匹配目录条目。
纯粹用于匹配 glob 模式与文件名样式字符串的函数是 fnmatch。
但确实,fnmatch的等价实现应作为独立模块,并可作为glob的依赖项。
没有人应该尝试使用类似fnmatch的函数和目录遍历从头实现glob。这并非 trivial 任务。
glob的遍历过程由模式引导,必须将模式分解为路径组件。它知道 “*/*/*” 有三个组件,因此遍历深度仅限于三层。同样,“dir/*” 包含一个固定匹配的组件,因此只需直接打开 “dir” 目录而无需扫描当前目录;若此操作失败,则 glob 操作失败。
若支持双星号 **(匹配多个组件),则最好将其同样集成到 glob 中。
如果支持花括号展开,这会增加另一层复杂性,因为花括号的不同分支可能包含不同数量的组件,例如 {*/x,*/*/x,*/*/*/x}。要实现 glob,如果能将花括号展开作为独立函数,使其展开花括号并生成多个 glob 模式,然后我们再将这些模式分解为路径组件并进行遍历,这将极大简化实现过程。
他们最终修复了这个问题,但 grunt 曾经使用过一种全局模式实现,无法在忽略模式中的通配符上进行短路。因此,我在扫描 node-modules 目录时发现它会删除所有匹配“node_modules/**”的文件。当我推出这个更新后,构建速度大大提升。
实现通配符的方式有很多种,其中只有少数几种是合理的。
> 但确实,fnmatch 的等效实现应作为独立模块,并可作为通配符模块的依赖项。
有趣,让我们看看 fnmatch:https://pubs.opengroup.org/onlinepubs/9699919799/functions/f…
实际上,fnmatch 主要做两件事:解析模式并将其应用于字符串。因此,应该有一个名为 “ptnparse” 的库来处理模式匹配,而 fnmatch 可以依赖于该库。
不过,仔细想想,“ptnparse”库负责匹配单个字符和多个字符的模式。我们应该将其拆分为“singleptn”和“multiptn”两个库,让“ptnparse”可以依赖于它们。
哦,还有 fnmatch 接受的那些标志,使得 fnmatch 可以以多种不同方式工作,让我们将这些标志分解为三个库,这样我们只需要引入我们关心的匹配器:pthmatch、nscmatch 和 prdmatch。然后我们可以根据我们在 fnmatch 中想要的功能来组合这些库。
这太完美了,现在如果我们不需要 fnmatch 的一部分功能,就不用包含它!
/s
这种分解方式导致了著名的 leftpad 问题。知道何时停止分解很重要。fnmatch 是一个功能比大多数系统调用更少的单一函数。我们可以将其与几个字符串函数打包,而不会造成太大开销。字符串级别的通配符匹配功能,可能应该与其他字符串操作函数一起放在普通的“字符串”库中。
重要的是,我建议将 fnmatch 放在“字符串”库中的提议,与您建议 fnmatch 不应被锁定在包含文件系统遍历组件的“通配符”库中的提议是一致的。
> 我无法想象在 [R]ust 领域会有什么不同
品味很重要;具有良好架构品味的程序员往往会使用支持他们工作的语言(如 Rust 或 Zig),或者至少不会妨碍他们的工作(C)。
因此,我认为你列出的问题在统计上比某些其他语言(从 COBOL 到 JavaScript)更少见。
> 开发人员太多了,包括我在内,他们并不总是能做出最佳选择。
你提出的这一点很重要:我认为,一群不协调的开发人员会创造出一堆“crates”(用埃里克·雷蒙德的话来说,就是“集市”模式),而一个有经验的单一语言设计师会创造出更统一的类库(“大教堂”模式)。
就个人而言,我希望 Rust 能够拥有更多“内置电池”的标准库,其中包含系统命名和命名空间的官方 crates(例如,包括所有主要数据结构)——为什么不能使用“stdlib::data_structures::automata::weighted_finite_state_transducer”,而不是一堆令人困惑的选择,比如“rustfst-ffi”、“wfst”等等??
理想情况下,这样的标准库应随语言发布时一同提供。但好消息是,它仍可在后续设计,因为Rust语言设计者足够聪明,将完全向后兼容的版本控制(但不包含技术债务)直接内置于语言本身。我对Rust 2030的期望便是这样的stdlib(甚至可通过当前crates的多元生态实现,只要这些细节对我们透明即可)。
我们无需进行假设,只需看看 glob crate 即可:https://crates.io/crates/glob
213M 下载量,不依赖任何外部 crates,一个源文件(其中三分之一用于单元测试),由 rust-lang 组织自己开发(还有许多 crates,这是人们在这场讨论中往往忽略的一点)。
哪个 glob crate?https://crates.io/search?q=glob
我翻到第 8 页,还有 glob 库。
第一个出现的,也就是说,下载量达到 2 亿的,也就是说,名称与搜索查询完全匹配的。
这更像是对 crates.io 搜索功能的评价,而不是 glob crates 的数量。我认为,如果你将标准的 glob crate 作为依赖项,那么你就会出现在搜索结果中。
找到一个避免这个问题的一个库是毫无意义的。你也可以在 Node 中找到很棒的库,但大家都同意 Node 有依赖性问题。
然而,当作者思考库的质量并无意中提出一个任意库作为例子时,Rust 版本却出人意料地质量很高。
glob 只是一个例子。他们并不是在询问一个具体的 crate。
此外,这个 crate 来自官方的 rust lang repo,因此不太容易出现个人行为不当的问题。这是一个非常糟糕的例子。
_> 此外,这个 crate 来自官方的 rust lang 存储库,因此不太容易出现个人行为不当的情况。
再次重申,这个帖子中人们要求语言提供的许多功能实际上是由 rust-lang 组织提供的:regex、serde 等。目标正在远离地平线。
Rust 在这方面的主要缺点是,它使依赖项的使用对最终用户来说变得透明。没有人愿意去考虑他们依赖了多少个库,以及维护这些库需要多少个无名的人,所以当 Rust 向他们展示这些信息时,他们会感到不舒服。这不是 Rust 的问题,而是软件复杂性的问题。
我认为父母是在建议比较和对比 Rust 和 npm 中的 glob 依赖关系。一次比较没有意义,但随机挑选十个使用频率较高的软件包进行比较可能更有意义。父母并没有真正提到 node 版本的情况。
npm glob 软件包有 6 个依赖关系(这些依赖关系又有 3 个以上的依赖关系,这些子依赖关系又有 6 个以上的依赖关系,……)。
正如你指出的那样,rust crate 来自官方存储库,虽然它不是标准库的一部分,但由语言维护组织维护。
也许这会使其成为一个不好的例子,但 npm 由 npm 的发明者维护,他自称“我编写了 npm 以及你可能使用的其他与 node 相关的 JavaScript 的大部分内容”。因此我认为这是一个很好的例子,因为我认为最关心语言的人正是这些包的维护者,他们(希望)正在实施他们认为对语言和生态系统最有益的最佳实践。
历史上,借用检查器一直是抵御缺乏品味的开发者的良好屏障。
不确定这种情况能持续多久。
其实不然,如今仍有许多大型库是由完全不懂行的人设计的。当然,你只有在非常熟悉该领域时才会注意到这一点。
动态类型语言则相反。
宏似乎弥补了这一点。某些库确实带有“C++模板编程”的风格。
值得指出的是,Node内置了通配符函数:https://nodejs.org/docs/latest-v24.x/api/fs.html#fspromisesg…,-%23)
> 此外,设计上也存在争议。一个 ‘glob’ 库是否应该实际读取文件系统并返回文件名,还是仅仅告知字符串是否匹配 glob 模式,并将重置操作留给用户?
Node.js 的标准库中也有一个实现此功能的函数(尽管它被标记为实验性):https://nodejs.org/docs/latest-v24.x/api/path.html#pathmatch…,-%23)
你所描述的关于通配符的问题并非缺乏品味,而是架构上的“缺陷”。
品味是史蒂夫·乔布斯所指的微软缺乏的东西。在软件中,品味体现在人性化、令人愉悦的设计上,几乎任何人都能欣赏。
编程语言不可能有品味,因为学习和理解它们需要花费时间和精力。Python 具有一定程度的优雅,Golang 的简单性也有某种难以言喻的魅力……但它们并不真正符合这个定义。
尽管如此,一些技术,如 git、Linux 或 Rust,即使对于普通开发人员来说,也显得特别晦涩难懂,更不用说普通人了。
Bun 也有一个全局变量 https://bun.sh/docs/api/glob
是的,这是 Rust 相对于 NPM 的一大优势——Rust 开发人员的技术更娴熟,crates 的质量通常更高。
随笔:我也注意到 Rust 库的质量。这让我对 async-openai crate 这种过度设计的混乱感到非常惊讶。
怎么能把像 openai 这样简单的 API 变成一堆乱七八糟的东西呢?最终,我使用了 reqwest,并手动创建了查询。我想这是大家都会做的事吧…
认为 OpenAI 的技术不值得一试的人,通常不会是开发和维护高质量 Rust 库的人。
我明白,但 OpenAI 是过去 x 年里软件领域最热门的东西,我原本以为会有某种官方客户端正确维护 Rust。
老实说,我有点震惊。
编辑:我最初误读了你的评论。无论你对 OpenAI 公司本身有什么看法,它都是一种重要的技术。能够轻松地与他们的 API 进行交互很重要。
也许在 Rust 尚未成为社交媒体和科技影响者视频的主流时,情况确实如此,但现在已经不是这样了。
https://crates.io/search?q=is-even
哦,不,Rust 社区的人开玩笑,太不专业了!!111
你会发现这些软件包实际上并没有被任何东西使用。
这是个玩笑。Leftpad 不是。
> 我在 npm 领域注意到的问题是,许多开发者缺乏品味。
编程与在高雅的艺术画廊闲逛不同。如果有人批评我的软件开发说我“缺乏品味”,我会尴尬到变成黑洞。
我知道这是 Hacker News,但这充满了自命不凡的气息。
工程学是一种艺术形式,工程师需要做出许多大小决策,而这些决策的优劣往往无法证明。品味无疑起着作用,有些工程产品明显体现了良好的或糟糕的品味。
不幸的是,这种特定的艺术形式需要精通数学和科学/计算机,因此非常难以接触。
> 审美确实起着作用,有些工程产品明显体现出良好的或糟糕的审美。
不。别自以为是。
哇,我信了!
说正经的:为什么你坚持认为艺术比工程更“高雅”,更值得?如果是这样,为什么工程要低于绘画?
在数学和一些硬科学领域,以及其他领域如编程的绝对基础方面,事情可以被证明是正确或错误的。在其他所有领域,我们需要反复应用模糊判断。
有些人做得不好,有些人做得很好。
如果你真的对细节感兴趣,这里还有更多相关内容:
https://www.paulgraham.com/hp.html
https://nealstephenson.substack.com/p/idea-having-is-not-art
> 为什么你坚持要建立一个智力等级制度,认为艺术更“高高在上”,更值得
更值得?你从哪里得出这个结论?
我在和一个机器人对话吗?
就是这样。
想象一下,如果一个木匠或建筑商建造出毫无品味的垃圾,然后嘲笑指出问题的人。你会雇佣他们为你建造东西吗?
这是SE文化的问题。
实际上,SE文化的问题在于,人们认为自己比实际聪明得多,仅仅因为他们从小就被称为天才,只因为他们知道如何开机和关机。
> 想象一下,如果一个木匠或房屋建造者在制造毫无味道的垃圾
你在说什么?这和软件开发有什么关系?你是说一个添加两个数字的函数有“味道”吗?
这句话确实没错,但“Rust”这个词有些过于具体了。总体而言,依赖关系越来越令人感到恐惧。供应链攻击已不再是假设,它们已经存在了一段时间。
如果我要设计一种新语言,我会非常感兴趣地加入某种功能系统,以便我能够安全地限制整个库树,而库可以以某种方式自愿提供它们需要/提供的功能。我认为这需要一种新语言,仅仅是因为生态系统需要从一开始就融入这一概念。
例如,考虑一个“图像加载库”。在大多数现代语言中,此类库几乎无一例外地支持直接从文件加载图像,仅出于便利性考虑。在支持能力概念的语言中,必须支持从流中加载图像,因此图像库要么需要你无条件地提供一个流,要么如果能力支持更丰富,你可以在清单中指定“我不希望你能够加载文件”,编译器会在编译时阻止“LoadFromFile(filename)”函数。将这种机制扩展到整个生态系统,我认为这将难以实现。如果正确实现,这将导致与现有系统严重不兼容,实际上等同于对整个生态系统的分叉。
我坦率地说,从长远来看,我看不出来还有其他解决方案,除非我们创造一个世界,其中绝大多数库在供应链攻击中变得无法被利用,因为它们无法打开套接字或读取文件,从而对攻击者毫无用处,而我们可以将攻击面缩小到仅那些真正需要深度访问的库。我认为,如果有一种语言采用了这种设计,你会惊讶于有多少东西实际上不需要这些危险的权限。
即使是倡导最小化依赖的文化,也只是在延缓不可避免的结局。我们已经看到Go包遭到供应链攻击,并且这些攻击已经渗透到人们的实际代码库中,而Go社区对大型依赖树的抵触程度几乎达到了极限。这还不够好。
你需要一种专用语言。
在你提到的图像加载示例中,你需要WUFFS。https://github.com/google/wuffs
在WUFFS中,大多数程序都是不可能实现的。它的“Hello, world”无法打印“Hello, world”,因为它根本无法做到这一点。它甚至没有字符串类型,也不知道如何进行输入输出,因此这两个任务要素都被排除在外。然而,它可以安全地处理不可信的文件格式,这是它的唯一目的。
我认为应该有更多像这样的专用语言,而不是我们大多数人学习的通用语言。如果您的工作需要六个、十六个或六十个 WUFFS 库来加载不同的图像格式,那也没关系,因为它们绝对不会做超出其范围的事情。然而,它们的速度非常快,因为它们从定义上来说不会做坏事,所以不需要像 C 语言那样编写“最好不要做坏事”的例行检查,也不需要像 Rust 语言那样添加编译器,而且它们可以很好地进行向量化。
Java和.NET框架几十年前就有了部分信任/能力机制。没有人真正使用它们,它们被废弃/移除了。
这并不坏,但没有内存/CPU隔离,它几乎毫无用处。当Sun破产时,隔离的JSR被放弃了。
更准确地说,是没有人正确使用它们。
这难道不意味着它们实现得不好?如果没有人正确使用某样东西,似乎问题不在于人,而在于事物本身。
我不这么认为。软件可能是唯一一个被认为可以错误使用主流工具,然后归咎于工具的“工程”领域。
其他领域的主流工具每五年就会改变吗?
公平地说,它们只在追逐趋势时才会改变,消费者并不关心软件是如何编写的,只要它能完成任务。
这双向适用,无论是用C语言编写的Gtk+应用程序,还是Electron垃圾,只要它能工作,他们就会使用它。
部分正确,因此它们被移除了,官方信息是操作系统安全原语是更好的方式。
也许我们需要在整体上培养一种更强的Sans-IO依赖文化。就像指出和批评不良实践和黑暗模式一样。一个新库(不应使用自己的文件访问代码)在HN上宣布,第一个评论是:“为什么你要自己做IO?”
编辑 – 注意这只是开玩笑。显然,那些在公众反对下开发的库并不是一个很好的衡量标准。虽然我同意,如果能有更多人了解Sans-IO原则,那将是一件好事。
我认为,对现有语言/生态系统进行改造并不一定是徒劳无功的。静态强制执行需要重写,但运行时强制执行可以在成本更低的情况下获得大部分好处。
只要所有库代码都是从源代码编译/运行的,编译器/运行时就可以用检查调用者特定权限的包装函数替换系统调用,并且如果语言的逃逸机制被使用,它可以拒绝编译或插入运行时异常。只要你接受规则被打破时触发异常,它可以与语言本身一样安全。
为不支持该功能的库文档化和分发能力配置文件需要一些工作,但类似的努力在TypeScript中已被证明可行。
我实际上曾出于兴趣开始开发类似工具,每次系统调用时,它会沿栈向上追溯,检查函数所属的共享对象,并与策略进行比较,直至找到明确允许或禁止的项。我认为它未必足够可靠到可以完全信任,但编写过程很有趣。
我非常喜欢这个想法,希望有一天能参与其中。自从我还是一个满怀憧憬的青少年,在 IRC 上听 Darius Bacon 解释他基于能力的操作系统想法(恰如其分地称为“Vapor”)以来,我就一直希望实现这个想法。
我认为在 Rust 中,使用类似 https://github.com/geiger-rs/cargo-geiger 的 linter 可以实现这个想法。Rust 编译器存在一些不健全的问题,例如 https://github.com/rust-lang/rust/issues/84366。这些问题需要修复或使用代码检查器进行覆盖。
我对此想过(尽管时间不长),似乎需要对与操作系统通信的方式进行非 trivial 的重构。例如,允许库“从流中读取”听起来很安全,直到你意识到它们可能使用与从文件读取相同的系统调用!
我喜欢这个想法。Rust 中也有类似的东西,但它是可选的,基于约定,并且只适用于“不安全”代码。具体来说,有一种趋势是,库使用“#![deny(unsafe_code)]”(如果当前 crate 中存在任何“不安全”代码,这会导致编译错误),然后向用户宣传这一点。但没有强制执行机制,库仍可为特定函数添加`#[allow(unsafe_Code)]`。
或许能力系统可以像当前的“功能”标志一样工作,但针对标准库,这意味着它们可以被递归计算。
备注:#[forbid(_)]无法被受影响的代码绕过(除非使用一个永远不会稳定化的夜间功能,该功能仅用于std宏)。
https://doc.rust-lang.org/rustc/lints/levels.html
啊,对,我忘了 forbid!
我认为无需设计过于复杂的语言来保护库免受隐式系统访问。如果唯一能导入系统 API 的地方是在入口程序中,那么库设计上就必须使用依赖注入来实现显式传递能力。
几乎可以对任何现有语言添加此限制,但问题是这会破坏现有库生态系统。
如果你现在想要实现这一点,Haskell可能是唯一的选择。
是的,从某种意义上说,Haskell的“效果系统”就是“能力系统”。我的效果系统Bluefin将能力建模为显式传递的值。例如,如果你没有“IOE”能力,就无法进行I/O操作。
https://hackage.haskell.org/package/bluefin
这可是一项艰巨的任务。第一个问题是你的能力系统将有多精细。无论是能力本身还是授予对象的范围。如果粒度不够细,一切都将需要一切,例如访问各种时钟可能被用于 DoS 攻击或作为侧信道攻击。不安全的内存访问可能会加快图像解析速度,但会破坏所有安全性。范围方面也存在类似问题。如果按依赖项分配,将迫使库作者移除有用功能或将库拆分为微小部件。如果按函数和模块分配,你将难以审计所有内容。最后,准确说明库/函数为何需要特定权限对开发者而言是巨大负担。我们从 JavaScript 引擎、容器化及 WASM 运行时中已知运行不可信代码的实际需求。但为每个函数调用都进行此类验证的开销过于庞大。
是否存在任何东西拥有这个想法的版本?对我来说这很有道理,但你说的对,用当前的语言实现几乎不可能。
比如Austral?https://austral-lang.org/spec/spec.html#rationale-cap
Austral 是一个非常酷的实验,我喜欢你链接的规范中投入的巨大努力。它很好地解释了能力(capabilities)和线性类型(linear types)的需求,以及它们如何相互作用。
Capslock for go
https://github.com/google/capslock
是的,但如果你追求的是安全性(至少对于原生编译的语言而言),你无法在语言层面强制执行这一点。你需要操作系统级别的功能支持,而一些操作系统确实提供了这种支持(如 SeL4、Fuchsia)。但如果你在虚拟机而非原生代码环境中,就可以强制执行功能,这就是 Wasm 通过 WASI 所做的事情。
Wasm + WASI 允许你通过显式接口在组件之间定义硬边界,可能大致沿着这些思路?
.NET Framework,仅限 Windows,(非 .NET,即 .NET Core)
Capslock 通过 Go 语言实现类似功能 https://github.com/google/capslock
有趣。我之前还没见过。我会查看它到底有多精细。我的首要关注点(自然)是网络调用,但调用本地服务应理想情况下与调用不源自顶级域的地址区分开来。
如果有人查看此帖子:它运行良好。使用 JSON 输出,它将显示检测到的每个“能力”(网络、任意代码执行等)的调用路径。我使用此命令将输出组织到电子表格中并快速扫描:
jq -r ‘.capabilityInfo[] | [.capability, .depPath | split(“ ”) | reverse | join(“ ”)] | @tsv’
TypeScript 生态系统支持这一点!如果环境中缺少文件操作等功能,相应的类将无法被加载,编译也会失败。
Haskell 是否在某种程度上通过 IO 单子实现了类似功能?不应直接进行 IO 操作的函数会采用更具体的类型签名,例如接受流并返回缓冲区等。
是的,尽管这可能被 unsafePerformIO 等函数打破。Haskell 的系统并非“绝对安全”的。
如果我将一个库中的组件传递给另一个没有这些权限的库,会发生什么?
> 我认为这需要一种新语言 [..]
语言(复数)… 没有单一语言能满足所有人。
这是所有软件开发中普遍存在的问题,与语言无关。我们正在做更复杂的事情,我们有更大的现有代码库可以借鉴,而且有许多理由使用它。最终,依赖项是不可信的代码,要让整个系统运行任意依赖项变得安全,还有很长的路要走(如果这甚至可能的话)。
在没有技术解决方案的情况下,所有其他解决方案基本上都涉及其他人必须审核和不断维护所有代码以及社会/法律信任体系。如果它被纳入 Rust stdlib,那么该团队将不得不处理它,并且对任何代码进行更改都会变得更加困难。
我认为不同语言的严重性有所不同,尽管核心问题是普遍存在的。拥有全面标准库的语言相对于那些内置功能有限的语言具有优势,因为后者甚至在最基本的功能上也依赖外部依赖项(例如,参见 Java/.NET 与 JS/Node 的对比)。轻量级并不总是更好。
> 拥有全面标准库的语言具有优势
我看不出来有什么优势。只是劣势的维度不同。以Python为例,它拥有一个庞大的标准库,里面充斥着我永远用不到的东西。有些人希望C++也朝这个方向发展——尽管开发者完全有能力自行实现。类似的问题也存在于像Qt这样的万能库中。“开箱即用”的语言会给核心团队带来更高的维护负担,从而导致所有用户都需要承担的各种成本:金钱、缓慢的演进、设计开销、使用最低共同标准的非专用实现、失去核心使命焦点等。
这是一个权衡。这些语言在标准库中进行任何演进都非常困难,因为整个生态系统都依赖于它,并且期望不会有破坏性更改。我认为 Rust 兼具了这两者的优点,因为依赖项非常容易安装,几乎与本机一样好,但同时还有多种选项和设计选择,易于演进,而且赢家自然会脱颖而出——这些选项和设计选择与 stdlib 组件一样高质量,因为它们吸引了人们/资金来开发它们,但同时又具有更大的灵活性,可以更改或替换。
> 如果它被纳入 Rust stdlib,那么该团队将不得不处理它,并且对任何代码进行更改都会变得更加困难。
我认为 Rust 确实需要多做些这样的工作。我在工作中每天都要使用 Go 和 Rust,Go 的库非常完善——标准库非常棒。而使用 Rust 时,找到合适的库并跟上许多简单的事情(web、tls、x509、base64 编码,甚至生成随机数)非常痛苦。
我不同意,在我看来,Rust 的核心库应该与抽象功能(内置函数、寄存器、内存、借用检查器等)进行交互,而标准库应该与操作系统功能(网络、io、线程)进行交互。其他任何东西都是 Rust 擅长实现的,将它们放入标准库会限制不同实现的采用。
例如,目前有 3 种 QUIC(HTTP/3)实现:Quiche(Cloudflare)、Quinn、S2N-QUIC(AWS)。它们都符合规范,但可能使用不同的 SSL 和 I/O 后端,并支持不同的选项。其中 2 种支持 C/C++ 绑定。2 种是异步的,1 种是同步的。
将 QUIC 集成到标准库中意味着所有这些选择都将提前确定并永久固定,且很可能无法为其他语言提供绑定。
Gilad Bracha 提出了一种非常有趣的沙箱化第三方库的方法:移除导入,并通过依赖注入完成所有操作。这样,如果你从未注入 IO 子系统,第三方代码就无法突破限制。而且没有额外开销,因为一切都基于能力。
更酷的是,如果你只想暴露读取操作,可以将 IO 库包装在另一个仅暴露特定命令(或自定义过滤等)的库中。
编辑: 我应该说明这不适用于系统编程,因为系统编程中总会存在不安全或行为未定义的代码。
听起来很酷,这是新话吗?
没错!这是该语言中众多酷炫概念之一 🙂
是的,但其中很多复杂性都是不必要的臃肿。我见过或参与过的几乎每个项目都充满了不必要的复杂性。人们天生倾向于过度复杂化事物,所有编程书籍,包括软件设计书籍,都专注于不重要的方面,而忽略了所有重要的方面。这令人极其沮丧。
然而,如果有人写一本书,正确地解释这些事情(一篇3000字的文章就足以让任何人成为10倍开发者),没有人会购买它。这个行业已经完了。
你指的是这篇文章吗?https://grugbrain.dev/
不。我写得更好。
引用一位著名开发者的话:“空谈无益。用代码证明!”
也许我们应该有一种方法,可以在隔离环境中运行我们使用的每个库,并采用类似QubesOS的结构。你的主代码是dom0,你可以创建多个TemplateVMs作为你的库,然后创建AppVMs来使用这些库。使用网络命名空间在这些进程之间进行通信。对于敏感工作负载(如金融、医疗等),部署此类方案是有意义的
无论使用何种语言,真的?我对此表示怀疑,因为在C或C++中通常不会遇到此类问题,因为添加依赖项更为繁琐,尤其是在跨平台环境中。
对于C++来说,这很滑稽,因为C++社区对正确的依赖管理非常排斥,同时又非常渴望使用第三方库,以至于委员会花大量时间基本上为社区进行依赖管理,将通常作为依赖项的大型功能直接内置到强制性的标准库中。
我肯定会漏掉一些,但据我所记得,C++ 26 将包含整个 BLAS 数学库、两种不同的延迟回收系统及相关基础设施、新的容器类型,以及一个非常复杂的通用单位系统。
这些功能都很酷,但它们是否适合标准库尚存疑,不过对于 C++ 程序员来说,这是使用它们最简单的方式……
里面一片混乱,而那些声称对Rust的crates.io中可能藏有可怕东西感到“担忧”的C++程序员,却对将数千万行未经测试的第三方代码复制粘贴到未来所有C++程序中这一行为毫不在意。
> 将数千万行未经测试的第三方代码复制粘贴到未来所有将要编写的C++程序中,这可能是个糟糕的主意。
真的有那么糟糕吗?(以Python 3.13标准库为例,其.py文件的代码行数不到90万行。)
如果某项内容在标准库中,那么它是由标准库提供商编写和审核的,而不是像你说的由随机的第三方编写和审核的。
对于 Rust 来说,它确实是一个随机的第三方。
所有开源标准库的维护者实际上都是“随机的第三方”。对于使用频率较高的生态系统依赖项(例如 Tokio,以及大量小型库,例如 `futures` 或 `regex`),查看过代码并经过实战检验的人数也非常多。
在 crates.io 上,一个好的启发式方法是查看两个数字:依赖项的数量和下载次数。如果两者都较高,那_可能_没问题。否则,我会手动审核代码。
这并非完整解决方案,尤其从安全角度考虑时,但若担心依赖项的整体质量,这已是个不错的近似方法。
有人专门负责维护标准库,开发和发布这类软件背后有一整套流程。
而Tokio库的维护者则在构建过程中决定下载二进制文件:https://github.com/tokio-rs/prost/issues/562 https://github.com/tokio-rs/prost/issues/575
祝你好运,希望你能从数十个 crates 中找到这样的问题。
你提供的链接正是支持我论点的完美例子。许多人注意到了这个问题,并且它很快得到了解决。
除了安全性之外,还有什么其他“质量”需要担心?
稳定性、正确性、测试覆盖率、性能。
你可以将任何内容归类为“安全”以适应特定用例,但这样做有何意义?
> 它是标准库提供商编写并审核的,而非随机第三方编写
所有三种现代 C++ 标准库当然都是自由软件。它们分别是 GNU libstdc++、Clang 的 libc++ 和微软 STL。由于这是一个庞大的库,你很快就会离开付费维护者的专业领域,进入一些志愿者为他们编写并声称良好的代码。这听起来像随机第三方。
现在, 我确信Stephan T. Lavavej(负责维护STL的微软员工,是的,名字决定论)是一位聪明且细心的维护者,因此如果你提交一个名为“_Upload_admin_creds_to_drop_box”的函数,他不会应用它,但同样,Stephen也不是超人,所以一些微妙的 trick 可能逃过他的法眼。类似的考虑也适用于GNU和Clang的维护者,他们没有奇怪的名字。
一个斯蒂芬·T·拉瓦维(Stephan T. Lavavej)的价值超过1000个随机的GitHub Rust开发者,其中一些可能是机器人、人工智能、业余爱好者、被收买的人或朝鲜间谍。任何库都有一个或多个斯蒂芬。
拥有付费维护者、代码审查、测试套件、严格的贡献准则等,是开源软件的最新技术,一些传递性 crate 依赖只能梦想实现。
_> 对于 Rust 来说,它实际上是一个随机的第三方。
不,出现在每个依赖树中的大量基础 Rust crates 都是 Rust 项目本身提供的第一方 crates。
因为大多数依赖项要么是由用户手动安装的,要么是发行版维护者提供的动态库并经过审核。这些依赖关系确实存在,只是更难看到罢了——https://wiki.alopex.li/LetsBeRealAboutDependencies
当然,有各种依赖关系,但与“cargo install crate-name”完全不同。Cargo让添加最简单的依赖变得异常轻松。
另一方面,C/C++更倾向于重新发明轮子,或直接使用第三方依赖。对于像sha256这样的功能,生态系统中本应存在一个经过充分测试的统一实现,但最终每个应用程序都拥有自己略有不同、大多未经测试且基本无人维护的版本。
应用程序仍然需要这些功能。当安装依赖项变得麻烦时,这种需求并不会凭空消失。如果一个库存在有缺陷,整个生态系统可以轻松获得修复版本。如果一个C应用程序所依赖的Stackoverflow代码片段存在缺陷,那么这个修复版本将永远无法进入该应用程序。
如果该错误是众多未维护的 crates 中的一个,且从未被发现,那么这对我来说毫无帮助。Linux 发行版旨在确保 C 应用程序动态链接到正确的库,而不是将代码作为供应商提供。然后,库就可以更新一次了。我认为这是唯一合理的方法。
在 crates.io 上查看一个 crate 是否未维护是很容易的。
也许如果它完全未维护的话,但这不足以解决问题,也许也不是真正的问题所在。
查看第三级依赖项是否未维护很容易吗?
> 当然,有各种依赖关系,但这与“cargo install crate-name”完全不同。
你不会安装一个 Rust crate 来使用它。在这个帖子中,已经有足够多的人在没有使用过 Rust 的情况下,就试图权威地谈论它了,如果你只是想凭无知来争论,请不要发表评论。
当然,我认为易于使用的软件是一件好事,Rust 的依赖项管理比 C++ 更易于使用 100 倍。
那么还有其他选择吗?我认为这不仅仅是 cargo-rust 的问题,因为你也可以用其他语言做到这一点。
确实如此,当不使用 vcpkg/conan 时。
别忘了 CMake。(它让添加依赖变得容易,但其他事情基本上变得不可能)
当然,尽管它备受批评,但除了 IDE 项目文件外,它在 C 和 C++ 构建工具中一直是最好的体验,包括与 IDE 的集成,就像那些项目文件一样。
我以为整个 UNIX 理念是“越简单越好”。
没有一个构建工具是没有问题的,我对 cargo 的不满之处在于,它总是从源代码进行编译,构建缓存需要额外的工作来设置,一旦超过纯 Rust,我们就会得到一个非常有创意的 build.rs 文件。
从内部讨论(https://internals.rust-lang.org/t/add-some-form-of-precompil…)来看,这似乎造成的问题多于解决的问题。
它需要巨大的存储空间,对于每个目标组合都是如此,即使问题得到了解决,Rust 社区的一些成员也会认为这是倒退。
包括我在内。它们难以审核,并且与 Rust 的 OSS 本质背道而驰。
系统编程语言应该支持所有部署场景,而不是固执己见。
你的意思是?语言本身支持这一功能,否则 serde 又该如何实现?
问题在于为 Cargo 构建工件获取存储和计算资源。但 Cargo 并非语言本身。
我也不理解对 CMake 的抵触情绪。现代 CMake(3.14+)仅需约 10 行代码即可构建基本源代码/库/可执行文件。你可以使用 CMake FetchContent 或 CPM https://github.com/cpm-cmake/CPM.cmake 来获取依赖项。无需使用第三方工具如 vcpkg 或 conan。
我认为 CMake 是完美的平衡。在添加依赖项之前,你需要编写几行代码并考虑一些事项,但通常不会太复杂。可能第一次尝试不会成功,但这没关系。
> 我们正在做更复杂的事情
根据我的经验,我们对同一件事有更复杂的方法,但目标并不更复杂。
这里也有类似的感觉。
Cargo让添加大量依赖变得如此简单,以至于很难不这样做。但这并非终点:即使我尽量谨慎添加依赖,几个依赖也可能各自拉取数十个传递依赖。
“那就不依赖它们,”你说。当然,但这意味着我不会写这个项目,因为我不会从头开始编写那些东西。我或许可以审核依赖项(如果它本身没有拉取 50 个包的话),但我无法合理地自己编写它。
C++ 则不同:我经常能找到不会拉取数十个传递性依赖项的依赖项。可能是因为添加依赖项更困难,也可能是因为生态系统更成熟,我不知道。
但感觉 Rust 的理念是拉取许多小包,所以似乎不会改变。这很遗憾,因为我更喜欢 Rust 语言,而不是 C++ 语言。感觉就像是用“不安全”来换取“必须从互联网上拉取大量随机代码”。
这是来自 Rust 子红迪网热门评论的链接:https://wiki.alopex.li/LetsBeRealAboutDependencies
我认为这里的一个关键点在于,部分差异仅仅源于感知,因为C/C++中的依赖关系由于是动态加载的,因此不太容易被立即察觉。不过从某种程度上说,这也有其优势,因为你很可能信任操作系统发行版的维护者会提供稳定且受支持的库。
正如其他评论者所说,也许这是 Rust 维护者可以提供某种扩展标准库的领域,他们并不保证永远向后兼容,但会保证持续修复安全问题。
> 这是来自 Rust 子红迪网(subreddit)的热门评论中的链接:https://wiki.alopex.li/LetsBeRealAboutDependencies
它也在这里发布过,就在这个线程之前:https://news.ycombinator.com/item?id=43934343
(过去也发布过多次。)
> 我认为这里提出的一个观点很有道理,即部分差异仅仅源于感知,因为C/C++中的依赖关系由于是动态加载的,因此不太明显。
重点不在于加载机制本身,而在于系统(尤其是在 Linux 上)会为你提供这些依赖项;其中相当一部分是预装的,其余则通过系统包管理器进行管理,因此你无需担心语言本身缺乏良好的包管理系统。
> 这里的一些差异只是由于C/C++的依赖关系不太明显,因为它们是动态加载的。
我的情况并非如此。我手动编译了所有依赖项(因为我需要交叉编译,或者因为我可能需要对它们打补丁等)。因此,我清楚地看到了 C++ 中我需要的所有传递性依赖项。而且,与 Rust 相比,我需要的依赖项少得多。
Rust 依赖性问题的一部分原因是,编译器目前只在 crate 级别进行多线程处理(夜间正在慢慢改进,但在推出并行编译器之前仍然存在一些错误),因此大多数库都会将自己分割成许多小的 crates,否则编译时间会太长。
编辑:此外,`cargo-vet` 对 crates 的分布式审计非常有用。还有 `cargo-crev`,但据我所知,它没有像 cargo-vet 那样得到大公司的支持,而且我上次检查时,它的评论数量和一致性都不如 cargo-vet。
https://github.com/mozilla/cargo-vet
https://github.com/crev-dev/cargo-crev
真不敢相信我之前从未听说过 cargo vet,听起来非常不错!
> 因此,大多数库都会将自己分割成许多小 crates,否则编译时间会太长。
实际上,这是否意味着可以挑选出真正需要的部分呢?
可以。此外,由于每个部分现在都更小了,因此更容易确保每个部分都能独立地发挥其应有的作用。这也意味着其他项目可以重用这些部分。最后一点的一个例子是 Regex crate。
Regex 被分为多个子 crate,其中之一是 regex-syntax:解析器。但该 crate 也是 150 多个其他 crates 的依赖项,包括 lalrpop、proptest、treesitter 和 polars。因此,其他项目也从 Regex 的拆分中受益。
是的,如果操作得当的话。Rust 有“功能标志”,可以有选择地启用依赖项,并在代码中有效地充当 `#ifdef` 保护。
我宁愿选择稍微不稳定的依赖项,也不愿面对 C++ 依赖项的混乱局面,包括 CMake、共享库、版本冲突等。C++ 的传递性依赖项可能也存在一些误解,因为它们通常是预编译的(因为编译它们非常麻烦)。
与 Rust 和 Go 的做法相比,整个 pkgconfig、cmake、autotools 等生态系统简直是疯狂的。
这也是 Linux 上的软件分发被推向使用容器,从而取消共享库的原因之一。我认为谷歌正在计划用其 C++ 替代品(Carbon)来打造自己的系统。
从我的角度来看,问题在于开发者希望控制分发。如果只是为了自己使用,这没问题,但如果计划让他人使用,那就另当别论了。你会发现最复杂的构建系统,仅仅是因为他们有一个想要特别支持的宠儿平台,这使得在其他平台上做任何事情都变得地狱般困难。
虽然可以做得更好,但当前的解决方案(如npm、Go、Python等)只偏袒开发者,而非维护者和打包者。
有维护者/打包者在为发行版打包时,实际上破坏了他人项目的例子,无论是提供有缺陷的版本、过时的版本等。
例如:Bottles、WebkitGTK(发行版通常会保留这些软件包,尽管这样做存在安全风险)
依我之见,操作系统供应商不应承担打包第三方应用程序的责任。
发行版维护者/打包人员是确保当前软件堆栈正常运行的关键。他们能够让数十亿行独立编写的代码协同工作,这实在令人惊叹。
不过,通过更人性化且通用的打包和分发方法(如 Cargo,甚至敢说 npm),维持这些软件的劳动成本可以大幅降低。我认为在此处可以找到开发者与发行版之间更好的桥梁。
> > 我认为在此处可以找到开发者与发行版之间更好的桥梁。
如今,每个普通人都可以创建自己的发行版(即使只是对Arch进行重新打包并添加Calamares和一些可疑的主题设置),为什么还要给开发者增加更多工作?
我们现在有Flatpak和Docker等工具,允许应用程序开发者忽略发行版并防止它们破坏系统,除非你是Ubuntu,一直在乞求被微软收购。
> 我认为在这里可以找到一种更好的开发者与发行版之间的桥梁.
我认为没有必要这样做。只需要纪律,使用稳定和成熟的依赖项,并记录构建过程。也许还可以为最流行的发行版提供一些指南/脚本。
> 这是Linux软件分发转向使用容器的原因之一
我认为人们选择在容器中分发软件,是因为他们懒得去学习如何正确地做这件事。如果这样做在成本上可行,他们宁愿直接安装软件并连同整个计算机一起发货。
需要“正确学习”的,遗憾的是,是一大堆混乱的遗留垃圾,这些垃圾理想情况下根本不应该存在。
这并非贬低使当前计算成为可能的巨大而关键的努力,这些努力在现实世界中可能不可避免。但软件分发需要进化。
> 可悲的是,需要“正确学习”的是大量不连贯的旧代码。
我并不觉得它们不连贯,也不觉得数量巨大。除非“巨大”的标准是“需要比询问大语言模型(LLM)并复制粘贴其答案更费力的事情”,否则我并不这么认为。
这不是“学会正确操作”的问题,而是需要付出巨大努力来应对不同发行版之间的任意差异,以及与那些宁愿携带已知漏洞的软件而非允许系统中存在两个库版本的发行版政策作斗争。
> 这是需要付出巨大努力来应对不同发行版之间任意差异的问题
对于开源软件而言,这根本不是问题:正确构建你的项目,让发行版自行处理。然而,开源项目往往做得不对,因为没人愿意花时间去学习。
> 以及与发行版政策抗争,这些政策宁愿发布带有已知漏洞的软件,也不允许系统中存在两个版本的库。
听起来如果你需要这样做,那你就是做错了。如果是重大更新(例如从 2.3.1 到 3.0.0),完全可以使用新包(例如 python2 和 python3)。如果你的用户需要两个版本相同的库(例如 2.3.1 和 2.5.4),那么作为开发者,你的做法是错误的。无需争论,只需学习如何正确操作即可。
> Rust 的理念是拉取许多小包
我不确定这是一种哲学,更像是一种对编译速度的务实考虑。任何做过大量 Rust 工作的人都知道,当项目变得太大时,需要将其拆分为单独的 crates。无法根据适当的抽象来组织代码,这有点令人遗憾,很多时候,我感到自己被迫为了编译器的性能而进行重构。
> 当然,但这意味着我不会写这个项目,因为我不会从头开始写那些东西。
你需要再仔细想想,以帮助你决定你的立场是否合理。
这让我也很困惑。隐含的解决方案是选择一种迫使你从头开始写那些东西的语言吗?
我的观点是,如果在该语言中,每个人都受到激励去使用更少的依赖项,那么一个我不会自己编写的随机库(因为它本身就是一个完整项目)将拥有更少的依赖项。由于情况并非如此,我只能选择使用该库并接受其传递依赖项,或者干脆不使用任何库。
在 Rust 中,我有时会想用 C/C++ 库(及其少数依赖项)来代替 Rust 替代品(及其无数依赖项)。
你需要稍微思考一下(可能不需要太费力),这有助于你判断我是否在胡思乱想,还是你可能并没有完全理解我的意思。
我昨天花了6个小时试图在Bullet外部编译Bullet示例代码,但毫无进展。更可能的情况是,很多软件根本没有被编写出来,因为C++和CMake让人头疼。
我认为CMake相当简单,我只使用了其中几个核心功能。通常,问题出在那些没有掌握基础知识的人完全错误的配置上。但我想,这适用于所有事情。
我认为https://blessed.rs在提供推荐方面做得相当不错,这些推荐通常无法被塞进标准库,但你几乎肯定会在某个时候需要它们。我真的很喜欢这个系统,它使得你需要特别关注的包通常都是在做一些非常具体的事情。
也要提一下 cargo-vet。
它允许你跟踪你“信任”的包。然后你可以选择转发信任那些你信任的实体所信任的包。
这让你可以制定这样的政策:“导入新的第三方包需要我们依赖管理员的批准。但谷歌声称已仔细审查的包是可以的”。
你还可以导出不同定义的“信任”。例如,Google会导出如下声明:
– “这个包包含不安全代码,我们的不安全代码专家已审核并认为其看起来正常”
– “这个包不涉及加密”
– “这是一个加密库,我们的加密专家之一对其进行了审核,认为它看起来没问题”
https://github.com/google/rust-crate-audits/blob/main/auditi…
基本上,它是一个比 blessed.rs 更正式、更详细的版本,你可以轻松识别所有“这不是标准库,但它有点像标准库”的内容,并将其轻松提供给你的团队,而无需完全采用 YOLO 模式。
它还可以提供一种“半YOLO”方法,支持诸如“这个包由tokio维护者拥有,这些人知道自己在做什么,应该没问题”之类的理由。我认为这对个人项目来说是一个不错的平衡。
希望看到类似的工具用于 Python。
已进行审查;这很扎实!
我觉得 leftpad 给包管理器带来了很坏的名声。我理解 OP 的犹豫,但对我来说这有点荒谬。
tokio是一个工作窃取、异步运行时。这是一个功能,它将是一个整个语言。OP认为审计整个Go语言是合理的吗?或者Node的V8引擎?V8的代码行数是tokio的~10倍。
如果Cloudflare使用Node,你会期望Cloudflare每季度审计V8吗?
顺便说一句,人们确实会审核 Tokio。我本人也多次审核过 Tokio。当然,并非所有人都这样做,但总有人会 🙂
如何进行这样的审计?是否需要打开 main.rs 文件(或任何入口点文件),并以广度优先搜索(BFS)的方式阅读代码和引用函数?
如果两个不同的依赖项使用了某个其他依赖项的不同版本,Cargo 是否会默认包含这两个版本?
这是我只见过 cargo 做过的事情。
如果没有一个版本同时满足这两个要求,它就会这样做。这是一件好事,因为大多数其他语言在这种情况下都会失败(当然,在某些情况下,即使在 rust 中也不会工作,如果这些子依赖项的类型在两个更接近的依赖项之间传递)。
> 如果两个不同的依赖项使用了某个其他依赖项的不同版本,Cargo 是否仍会默认包含这两个版本?
不会,Cargo 会使用半版本兼容性进行解析并选择最佳版本。Nuget 对于 C# 也有类似的实现。
> 这是我唯一见过 Cargo 这样做的情况。
npm 也会这样做(这通常会导致 node_modules 目录中包含大量文件,但有时“提升”常见依赖项会有所帮助,Yarn 的 PnP 功能会挂钩到 Node 的 require() 并以 ZIP 格式保留包,而 pnpm 则使用符号链接/硬链接)
过去(不是在 Rust 中,而是在其他语言中),对于重要的系统,我制定了尽量减少对这些语言特定软件包存储库的依赖的政策,对于确实要使用的,必须将其复制到我们自己的存储库,并在使用前审核每个更新。
但这种做法并不适用于所有情况。例如,Web 前端开发者的工作环境可能是最糟糕的,以至于如果你不采用同样的鲁莽做法,往往无法在合理的时间内完成许多事情。
我现在也看到了不透明的自托管人工智能工具和模型的“货运崇拜”现象。为了学习和实验,我会花更多时间来充分划分单个工具,而不是使用它。
这个周末,我正在重拾我的 Rust 技能,为一个小型开源就业项目做准备(因此我无法在这个项目上投入昂贵的依赖管理)。困扰我的主要问题不是内存分配管理,而是看着UI和异步库的数千个传递依赖爆炸式增长时那种令人沮丧的感觉。这些依赖中总有一个会被攻破,如果还没被攻破的话,而只要一个被攻破就足够了。
最佳做法是仅将CI/CD系统连接到官方内部仓库。
开发人员可以在工作站上添加任何他们想要的内容,但如果未经授权就推送代码,构建服务器将会很悲惨。
将“最佳做法”替换为“唯一安全的方式”。
任何其他做法都可能在“为了方便”或“就这一次”的名义下被滥用。
此外,添加 crate/gem/module/library 的流程与其他流程一样:许可证审查、代码审查、订阅相应的邮件列表或其他公告渠道,以及责任分配。一旦流程启动,除了代码审查之外,所有这些流程都可以非常快速地完成。
所有问题,至少在某种程度上,都是依赖链管理问题。
我同意在引入第三方依赖时存在一定摩擦是推动人们权衡依赖价值与成本的关键(而许可证审查、代码审查、频道订阅等环节至关重要却常被忽视),但对于传递性依赖应如何处理?以及这些依赖的依赖关系又该如何处理?
大多数解释型或源代码分发的语言的依赖关系树都令人难以置信地复杂,即使审查其中几个,在许多开发环境中也几乎不可能实现。
你清楚地理解了问题,但尚未找到解决方案。
这是一个显而易见的解决方案,但许多人对此感到不快。
或许这种厌恶感让我视而不见。
您愿意为我们这些反应迟钝的人,非常明确地指出这个显而易见的问题吗?
“大多数解释型或源代码分发语言的依赖关系树都荒谬至极,”
因此,您必须仅使用依赖关系树不荒谬的软件。
这意味着必须放弃那些依赖关系荒谬的软件。
> 开发人员可以在自己的工作站上添加任何他们想要的内容
被入侵的开发机器也是一个问题。
确实,因此我们可以更进一步,为开发人员设置受限账户,我可以告诉你,大多数HN上的用户都会讨厌在这样的企业环境中工作。
我会离开。如果我不得不每天向IT安全部门乞求某些东西,那就不值得了。我之前经历过这种情况,那真是令人沮丧。而且这甚至不是他们的选择,CEO在参加过一次安全讲座后就下令“不能信任任何人或任何东西”。不过你可以相信,我待在那里的时间不会太长 🙂
毫无疑问,尽管这始终是就业市场的问题,但在全球许多地方,开发者的工作与其他办公室工作并无太大区别,许多人首先要满足于能有一份工作。
有一些声音试图解决这个安全风险(例如,这个新 RFC 的支持者:https://github.com/rust-lang/rfcs/pull/3810)。然而,出于某种原因(可能是文化因素),目前尚未形成改变现状的强大动力。
> 目前尚未形成改变现状的强大动力。
这是一个复杂的问题,存在大量部分解决方案,每种方案又有无数种实现方式,且往往没有明确的优胜者
也就是说,这是很难通过共识来解决的问题。
例如,扩展标准库的想法已经存在很久了(自 Rust 诞生以来就存在),但多年来,人们出于各种原因认为,将其作为一个独立的项目/库可能是最好的选择。其中一个原因是,“标准库是代码死亡的地方”这句话对于多个生态系统来说非常正确 (最明显的是 python)。
附带说明一下,ESL 不会减少 LOC 计数,只要你完全测量 LOC,而不“跳过”一些依赖项,它就会增加 LOC 计数。
坦率地说,rust RFC 流程已经变成了一种 CF。
Rust 语言的 RFC 提案多达数千个,但其中只有极少数被采纳。在我看来,这种情况使得任何特定的提案都难以脱颖而出。此外,这几乎不可避免地导致重复工作。
对于大多数人来说,Rust 的 RFC 流程实际上已成为一个死信箱。
我认为他们可以成立一个 RFC 审查流程委员会(如果今天还没有的话),并根据建议创建多个领域特定团队/小组,及时审查 RFC。
Rust 的酷炫之处在于你可以自己实现异步。你无需受制于任何特定的实现。
除了使用不同异步库的库在 Rust 中通常不兼容之外。
C++ 中也是如此,.NET/C# 和 F# 中部分如此。
或者完全不使用异步。
我们需要一个类似“成熟”的术语来描述已完成的依赖项。成熟的依赖项具有两个特征:
1. 明确的范围
2. 很少更改
Nomad 有许多这样的依赖项(msgpack、envparse、cli 等)。这些依赖项数年不变,因此依赖项管理负担迅速趋近于零。这对没有自身依赖项的“叶子”依赖项尤其有用。
我希望库能明确表示其“成熟”意图。我会选择一个成熟的 Protobuf 库,而非一个不断调整其易用性和性能的库。持续的迭代改进通常是有益的,但有时成本不值得。
Java有时通过在标准库中添加经过稍作整理的实际标准版本来实现这一点。Java 1.3没有正则表达式,但大多数人都在使用相同的Apache Commons组件,因此Java 1.4添加了与之完全相同的正则表达式。Java 的日期处理功能令人头疼,因此人们主要使用 Joda-Date;后来 Java 版本添加了与 Joda-Date 功能相似的实现。等等。
这是一种相对轻松的方式来获得一个尚可的标准库,因为你添加的内容最终会因自身优势而流行起来。
一旦添加,使用标准库是阻力最小的路径;而且作为标准库,你有一点希望有人会关心维护它。如果你需要为特定用例构建更好的版本,仍然可以这样做,但基本使用已经包含了所需的组件。
我对这种观点很有同情心,但我也希望我们能提醒自己。我们正在要求业余项目达到专业水平。
如果你想要一个成熟的 Protobuf 实现,你可能需要购买一个。期望某个互联网上的家伙/姑娘免费为你维护一个似乎不太明智。
> 我对这种观点很有同情心,但我也要提醒大家。我们正在要求业余项目达到专业水平。
没有人要求业余项目达到专业质量标准。最多,他们要求业余项目明确标注其性质,而非宣称“这是一个可用于你的项目的[x]库,且具备[维护/性能/兼容性/等]预期”。
以简历为导向的开发似乎导致人们过度宣传其业余项目,将其包装成可供外部用户使用的软件。
> 如果你想要一个成熟的 Protobuf 实现,你可能需要购买一个
没有软件是这样开发的。不知为何,库总是免费的。几乎没有人会购买付费库。
> 最多,他们要求业余项目明确标注其业余性质
这也需要工作。你不能要求业余程序员为你筛选严肃/维护良好的项目。作为有工作的专业人士,你必须自己做这件事。如果某个 GitHub 上的陌生人在读我文件中声称项目有维护,但实际上在说谎。相信他的人才是傻瓜。他可能才 12 岁,而你本应是专业人士。
> 没有软件是这样开发的。
这完全不准确。在我日常工作中,我们至少会为3-4个第三方库付费,这些库要么有支持合同,要么是专门为我们开发的并附带支持合同。除此之外,还有大量软件产品、数据库、编辑器、Prometheus、Grafana等我们付费使用的工具。
软件从业者严重低估了商业人士愿意为“有人可联系”而付费的程度。它并非像风投公司所热衷的那样“无限可扩展”,但无疑是一个巨大的商业机会。
此外,在游戏开发领域,还有许多常见的付费中间件库:FMOD/Wise、多人网络SDK等。
再仔细想想,似乎软件库难以找到良好的授权销售方式,根本原因在于授权执行机制。Unity 和 Unreal 拥有内置的授权系统,并会对游戏开发者进行严格执行。而普通服务器软件则没有这样的机制。
这意味着作为代码生产者(一旦代码交付后),你唯一的威胁就是停止服务。这意味着销售许可证的唯一方式是:
* 构建自己的许可证服务(或提供SaaS)
* 以高价一次性出售代码
* 销售服务合同
> 不知为何,库总是免费的。几乎没有人会购买付费库。
我怀疑这在很大程度上是因为,制定一个既对消费者有吸引力又对作者可持续的许可(编辑:定价!)模式几乎不可能。
这不是一个支持“成熟”标签的论点吗?为了避免那些没有维护意图的业余爱好者?
也有很多由业余爱好者维护得很好的项目,以及大量曾经付费购买的弃置软件
> 也有很多由业余爱好者维护得很好的项目,以及大量曾经付费购买的弃置软件
确实如此。我绝不会因为某个项目是业余项目就忽视它。你只是不能指望它保持那种状态。
我的基本观点是,业余项目永远无法承担责任。如果你有支持合同,你就有权期待获得支持。如果你没有,那么任何期待都是不合理的,你所获得的一切都是赠予。
“成熟”标签同样存在问题。你期待作者为你贴上标签。这是工作。如果你从公共资源中获取,必须尊重他人可以随意标注的权利,而缺乏动机的笼统谎言并不违法。
是的,这是个好点子
这是一个很好的观点!我提到的所有库都是由公司创建和维护的。业余爱好者,如往常一样,可以随心所欲地做任何事情,而无需我的评判。:)
我必须说,我从我编写的那个几乎不需要维护的envparse库中获得了极大的满足感。能够将任何项目真正视为完成,是一种难得的享受。
我觉得Go生态系统几乎是偶然地具备了这一点——标记为v0.X.Y的模块处于不成熟阶段且仍在开发中,而v1及以上版本则已成熟,更改主要限于 bug 修复。我认为有些人甚至会遵循这一惯例!
Cargo 包的一个优点是功能标志。如果一个仓库依赖过多,那么是时候打开一个问题或 PR 来将它们隐藏在功能标志后面。我经常这样做,即使包可以使用核心和分配,但它仍然需要标准库。
Cargo 树在查看依赖关系树方面非常有用。我忘了它是否计算行数……
> 用于查看实际编译到最终二进制文件中的行,
这其实没什么意义,因为很多进入二进制的函数会被内联到如此程度,以至于它们常常成为 ‘main’ 函数的一部分
100%,我仍然希望 npm 能够支持功能开关。有没有已经实现这一功能的包管理器?我非常希望能够扩展我们的内部库,加入框架特定的代码
我曾想为流行的 swc 项目(https://github.com/swc-project/swc)做贡献。我克隆了仓库,运行了构建,结果硬盘上足足少了 20GB。解析器本身(https://github.com/swc-project/swc/blob/main/crates/swc_ecma…)有十几个依赖项,包括 serde。
与此同时,用 JavaScript 实现的最重的 JavaScript 解析器反而更轻量级。
我决定放弃这个项目,把时间花在其他地方。
我用 “git clone –depth 1 …” 构建它,而 cargo build –release 的构建结果是 2.9GB(目标文件夹中为 2.3GB)?
Rust 会生成大量荒谬的调试信息,因此默认的调试构建要大得多。
零成本抽象并不意味着零成本调试信息。事实上,所有被优化掉的内容都会被有意地完整地保留在调试信息中。
你还应该添加开发构建
我统计了 13 个依赖项,其余均为内部依赖。其中是否有任何依赖是多余的,或者仅在特殊情况下需要?Serde 似乎正是应该使用外部依赖的典型案例。
此外,仓库大小似乎是一个极不相关的指标。
13 > 12,因此依赖项超过了十个。如果你看看 acorn 或 babel/parser,它们几乎没有依赖项。
仓库大小与构建所需时间直接相关,这对于我参与该项目至关重要。
> Serde 似乎正是应该使用外部依赖的典型案例。
我无法理解解析器为何必须依赖序列化库。
>13 > 12,因此依赖项超过十个。如果你看看 acorn 或 babel/parser,它们几乎没有依赖项。
哪些是多余的?
使用依赖项是有充分理由的。如果有人已经解决了你需要解决的问题,重复努力是没有意义的。
>仓库大小直接影响构建时间,这对参与项目贡献至关重要。
完全错误。两者之间没有任何内在关联。
>我看不出来解析器为什么必须依赖一个序列化库。
因为你看不出来,所以就不存在吗?
如果你无法指出为什么这是多余的,那么讨论这些是毫无意义的。
我认为讨论这个没有意义,因为显然你属于“依赖项是可以接受的”阵营,无论是否有正当理由,而另一个阵营是“除非必要,否则避免依赖项”。你刚刚提供了一个依赖项爆炸的例子。
> 因为你看不见理由,所以就没有理由?
据我所知,其他基于JS的解析器都没有做复杂的序列化。你可以想出需要它的理由,但作为解析器的用户,我希望占用空间尽可能小,这是硬性要求。事实上,这就是我从未在严肃项目中使用swc解析器的原因之一。
你只是在胡说八道。你仍然无法解释为什么这些依赖项是多余的。
你个人可能不需要这些功能,这再无关紧要不过了。其他解析器在做什么也再无关紧要不过了。
> 你仍然无法解释为什么这些依赖项是多余的。
不,因为我无需回答这个问题。我可以选择不使用这个项目,就像我对待npm项目一样。有一个项目代码大小为500KB,依赖项有120个,而另一个项目代码大小为100KB,依赖项只有10个且维护良好?只要它能满足我的需求,我当然会选择后者。我不在乎另一个项目为什么有120个依赖项,也不试图为其辩解。
你为什么抱怨一个你不在乎的项目使用了13个依赖项,而据你所知,这些依赖项对功能来说都是绝对必要的?
>有一个项目代码大小为500KB,依赖项有120个
因此,使用13个依赖项的项目就是做错了?你在说什么。显然,JS生态系统中存在对依赖项的过度使用,谁在乎呢?
他们最初的抱怨是关于该项目编译时占用20GB磁盘空间。
他们还指出解析器依赖于一个序列化库,所以你关于父级认为依赖项是必要的观点也是错误的。
另一点是,这种普遍存在的被动攻击性、含糊其辞、部落主义、盲目捍卫某些技术的态度,充分暴露了他们的受众。
请在评论前先阅读对话内容。
我同意依赖未知依赖项存在风险,但这偏离了重点。依赖项数量和磁盘空间其实是相对的。
> 与此同时,用 JavaScript 实现的最重的 JavaScript 解析器反而更轻量级。
最轻量的 JavaScript 程序依赖于 V8 运行,而 V8 的依赖项数量多出几个数量级,其中大部分你可能从未听说过。
至少 Cargo 使我们更容易清楚地了解程序的依赖项。
依赖项的数量并非完全任意……
如果你只有一个巨大的依赖项,更容易跟踪是否处于最新更新状态,而且误操作导入拼写错误的依赖项的可能性也更小。
此外,如果你在企业环境中,你将减少100页的SBOM报告。
哪个更容易受到攻击,一个由十个人开发的10万行代码的项目,还是十个由单个维护者开发的1万行代码的项目。
使用Cargo跟踪最新版本非常简单。
与我兄弟的评论不同,我并不从事SBOM工作,但若考虑社会动态和信任的含义,不难看出信任一群10个陌生人比信任10个独立的陌生人风险要小得多。
考虑概率
我从事SCA/SBOM工作。
>哪种情况更容易存在漏洞,
归根结底,你面临的风险是,这10个包中的一个可能会被外部势力控制,然后下一个版本突然开始运行比特币矿机,或者从你的CI/CD中窃取一切,甚至接管你的客户。
而且,这个数字绝不是10(至少对于JS来说),而是数百,如果你的团队足够疯狂,甚至可能是数千。
不,这与V8或任何运行时几乎无关。这些解析器可以在任何足够新且可靠的运行时上运行,包括浏览器和Node.js。如果你查看实际代码,它们使用的是JavaScript语言中基本的API,这些API在几乎任何其他语言中都能找到。
> 依赖于V8运行,而V8有成百上千的依赖项。
实际上,这并不正确。(或者至少在一段时间前是这样。)我曾经和一群前V8团队成员合作过,他们非常讨厌第三方依赖项,也不信任任何他们没有编写的代码。他们确实使用了一些第三方库,但对他们来说,大部分情况下,他们都试图自己掌控一切。
他们也是谷歌..
也就是说,他们有能力重写一切..
能够承受“不是我们发明的”综合症..
而且与大多数其他项目相比,他们面临着巨大的供应链攻击威胁 (因为他们最终运行在几乎所有台式机和一半的手机上)
这对大多数项目来说是不现实的,不仅在资源和时间投入方面,而且重新发明/编写一切并不一定能减少 bug,如果你没有可靠地访问资源和专业知识。大多数公司不得不接受拥有许多平庸的开发者,以及非常紧张的资源限制。
我认为编写V8的人一直都是这样,即使在他们的公司被谷歌收购并转而编写V8之前也是如此。
我认为这是“文化”问题。使用Go时,你经常会发现开发者/项目自豪地提到只使用了少量或仅有几个非标准库依赖项。来自 Go 的人在构建 Rust 项目时,看到屏幕上滚动着一页页的依赖项,会感到非常奇怪。
Go 有更丰富的标准库和“肥大”的运行时,内置了绿色线程(基本上是一个异步运行时)和垃圾回收,因此你可以获得更多现成的功能,最终使用更少的依赖项。
我尚未遇到过不引入大量第三方代码的 Go 项目。似乎你对“文化”的描述有点夸张。
> 我尚未遇到过不引入大量第三方代码的 Go 项目。
这些项目完全没有依赖项。在 Go 生态中并不罕见。
– https://github.com/go-chi/chi 19k 星
– https://github.com/julienschmidt/httprouter 1.6万星标
– https://github.com/gorilla/mux 2.1万星标
– https://github.com/spf13/pflag 2.6k 星标
– https://github.com/google/uuid 5.6k 星标
许多其他库的依赖项很少。
是的,虽然我看到过一些优秀的库遵循了尽量减少依赖项的实践,但我对 Docker 带来的依赖项数量感到有些困扰 [1]. 我一直在寻找替代方案来满足我的 Docker 需求,但 Podman、Buildah 以及我检查过的其他一些工具的情况类似。它们引入的依赖项数量大致相同……如果有人知道一个精简版的 Go 库,可以用于从 Dockerfile 构建、拉取并运行容器,我将非常感激任何建议。天啊,Docker/Moby 甚至没有正确使用 go.mod。
[1] https://github.com/moby/moby/blob/master/vendor.mod
哇,这太庞大了。我想,对于面向最终用户的流行开源软件来说,由于用户对需要依赖项的功能的需求,不可避免地会积累依赖项。
我认为Telegraf做了一个不错的折中方案:开箱即用时,它自带了大量监控工具[1]来监控一切,但它允许你通过构建标签只构建所需的部分,甚至提供了一个工具来从你的Telegraf配置中提取这些标签[2])。但许多供应链安全工具假设go.mod中的所有内容都被使用,这可能会导致大量噪音。
[1] https://github.com/influxdata/telegraf/blob/master/go.mod [2] https://github.com/influxdata/telegraf/tree/master/tools/cus…
谢谢!这是一个有趣的方法。我之前没见过这种做法。我认为在单仓库(monorepo)中,更好的方法可能是为每个模块使用独立的 go.mod 文件,这样用户可以单独配置所需的部分。但这种做法似乎并不常见。
针对文章结尾提到的一个问题,以下是我作为基线的[部分]解决方案。
整理并收集你使用和信任的库。这可能需要你自己创建多个库。可以说是一种“重新发明轮子”的行为。如果操作得当,即使前期投入的时间成本,长期来看也能节省开支。我属于少数派,但我尽可能自己编写库,而我使用的第三方库通常是我熟悉、使用过并验证过其自身依赖关系树较浅的库。
这是否可持续?我不知道。但这是我目前能想到的最佳方案,以便使用我认为在多个领域中最佳的编程语言。
有很多轻量级、优秀的库,我会毫不犹豫地使用,且适用范围广泛。示例:
  - num_enum
  - num_traits
  - bytemuck
  - chrono
  - rand
  - regex
  - bincode
  - rayon
  - cudarc
更重,并且会定期遇到版本兼容性问题,但对于 GUI 程序非常有用:
  - EGUI
  - WGPU
  - Winit
从消极的角度来看,Rust 的网络生态系统可能因异步和混乱的依赖关系而永久丧失。嵌入式系统也正在走向这条路,但我对此更有希望,并且正在尽我所能打造自己的工具。
Rust 在异步方面确实做了一些不恰当的选择,它污染了所有东西,但又不够通用,所以现在你只能依赖运行时,这使整个生态系统分叉了。这几乎与 Dlang 中的 phobos/demios 问题一样,但 Tokio 却取代了它。人们不再使用 Rust,而是使用 Tokio。
尽管 PLT 着色之争,Rust 仍会蓬勃发展。异步框架通常通过赢家通吃的动态占主导地位。大多数关于异步着色的博客文章都是故作高深的胡说八道,我因为指出他们的知识破产而在这里遭到了严厉的审查。无论 HN 的官方规则是什么,无知者完全脑死亡的道德论调都应受到严厉的嘲笑。
现实世界的软件生态系统发展缓慢,需要多年的争论才能发生转变。
——来自 HN 最直言不讳的 Rust 批评者
GP 的抱怨并不是关于着色,而是关于基本异步 API 不足以完成大多数任务,因此你不仅拥有着色函数,现在还必须绑定到异步运行时。如果大多数异步 Rust 代码都能与异步运行时无关,尽管仍然存在着彩色函数的问题,但世界会变得更好。
当然,即使现在,这种情况也比标准化错误的解决方案要好得多。Rust 中广泛使用的每个异步运行时对许多问题都有不同的解决方案,选择并不明显。
例如,`tokio::spawn()` 返回一个任务句柄,允许任务在句柄被释放后继续运行。`smol::spawn()` 在任务句柄被释放时取消任务。
异步取消需要基础设施机制,而合理的设计方案有多种。
让生态系统自然演进是找到最佳设计并最终纳入标准库的绝佳方式,但这需要时间。
> dotenv 已不再维护。
从 .env 文件加载密钥到环境变量,你可能需要多少维护工作?
我同意你的总体观点,但就这个具体功能而言,我要指出的是,设置当前进程的环境变量是不安全的。我们花了很多时间才意识到这一点,因此该函数直到 Rust 2024 版本才被标记为不安全。
实际上,这意味着调用 dotenv 也应该被标记为不安全,以便调用者能够将其放置在正确的位置来确保安全。
如果没有人维护这个 crate,那么这种情况就不会发生,有人可能会在不恰当的时候尝试加载环境变量。
好,我感兴趣了——在当前进程中设置环境变量为何不安全?直觉告诉我这并非内存所有权层面的不安全,而是与竞态条件相关?
无论问题是什么,“设置环境变量是不安全的”这一说法对我来说非常有趣,我迫切希望看到一篇博客文章来解释这一点
这是一个长期存在的 bug,setenv 和 unsetenv 不是线程安全的
https://www.evanjones.ca/setenv-is-not-thread-safe.html
我认为使用 setenv 简直是个糟糕的主意。
你能详细说明最简单的替代方案是什么吗?
简单来说,就是在创建新线程后不要设置任何环境变量
https://doc.rust-lang.org/std/env/fn.set_var.html#safety
我认为人们仅凭仓库的提交次数来评判其质量非常可笑,仿佛10,000次提交就意味着代码质量更高。
维护者已在仓库的README文件中明确发出警告,因此即使该仓库得到维护,仍不具备生产环境部署条件。
> 注意!这是 v0.* 版本!请预期会出现各种 bug 和问题。提交 pull request 和问题报告强烈推荐!
https://github.com/dotenv-rs/dotenv
这是一个似乎被广泛使用的逃生通道。没有人愿意发布一个带有向后兼容性保证的 1.0 版本。
ZeroVer https://0ver.org/
讽刺的是,一个长期未发生变化的“无人维护”的项目是升级到 v1 的好候选者,而每天都有新突破性提交的项目则是糟糕的候选者。
Rust 开发文化对过去 3 个月内未发生重大变化的代码过敏。太容易了,太稳定了。
另一方面,从环境中加载 .env 文件至关重要(因为你通常会通过 .env 传递机密信息)。我不想自己维护它,也不想与其他 xxK 个项目共享,以防存在漏洞。
问题在于加载和设置环境变量(这是 dot env 库的默认行为)
_由于 unix/posix_,这基本上是不合理的
没有办法解决这个问题
因此,即使从 Rust 早期(甚至可能是 1.0)开始就已知它并不完全安全,但设置 env 并未被标记为不安全_
它并不不安全并不是一个疏忽,而是一个已知的不完全合理的设计决策,最近已经重新审视并更改了
在测试你提供的那个非常小的固定功能是否正确后
不
一些小型“已完成”且经过充分测试的库因无人维护而被标记为安全问题,似乎开始成为一个问题
我想知道在 crates.io 层面上,在软件包上添加“依赖深度”标签会有什么好处。比如,一个软件包只能依赖于依赖深度低于它的软件包,而软件包们会竞争以较低的依赖深度作为自己的标志。
每当我幻想我的理想语言时,这是我想到的一个功能。
我最近使用 Axum 编写了一个非常基本的 Rust Web 服务。它有 10 个直接依赖项,总共 121 个已解析的依赖项。后来,我使用 Jetty 用 Java 重写了该服务。它有 3 个直接依赖项,总共 7 个已解析的依赖项。简直太疯狂了。
我认为依赖项的数量并不是一个有用的比较指标。Java 运行时已经实现了在 Rust 中必须使用库才能实现的功能,这是设计上的选择。Rust 还有更精简的 std。两种语言对此都有不同的限制。
> 解决方案是什么?
大事情使用现成的库。小事情开源代码,可能从适当许可的开源库中抄袭。你的代码会膨胀到一定程度,但减少了对外部代码的审核需求,降低了供应链攻击的风险。尽管如此,大库仍然是一个问题,但你不会把所有东西都开源。
这不仅仅是 Rust 的问题,而是所有语言的问题。
> 大型功能使用现成的库。
我应该补充一句:“而且原因显而易见”。
计算机科学界不是在过去几十年里一直吹捧代码复用,直到它终于在更大规模上实现吗?要让代码复用真正实现,我们需要具备良好命名空间、打包和分发渠道的编程语言。C 语言永远不会拥有 Java、C++ 和 Rust 这样的库生态系统。现在,我们突然面临一个非常令人担忧的供应链问题,让人联想到《信任信任的反思》中的情况。该怎么办呢?我们无法承担将所有东西都开放代码的成本,所以不会这样做,但我建议将所有“小”东西开放代码,特别是在大型项目和大型库中。好吧,也许人工智能革命会拯救我们。
Rust 至少对这个问题有一个部分的解决方案:功能标志。许多库使用它们来控制功能,否则会引入额外的依赖项。(事实上,我相信有对应依赖项名称的标志的特定支持。
所有关于改进 Rust 依赖处理的评论和建议对我来说都很有用。为了应对当前依赖蔓延的问题,在情况发生改变之前,我使用了一些工具。为了避免为每个新项目都进行设置,我制作了一个模板项目,只需解压缩即可创建新的 Rust 项目。
我发现有用的工具包括:
cargo outdated # 检查依赖项的新版本
cargo deny check # 检查依赖项许可证
cargo about # 生成已使用许可证列表
cargo audit # 检查依赖项是否存在已知安全问题
cargo geiger # 检查依赖项是否存在不安全的Rust代码
我尚未找到满意的cargo工具用于生成SBOM,因此安装了syft并运行该工具。
cargo install-update # 保持这些工具更新
cargo mutants # 与依赖项无关,但值得一提,在测试时使用。
一旦配置了所有这些工具,只需解压缩一个模板就足够了。
欢迎提出其他或额外工具的建议!
免责声明:我不是专业的 Rust 开发人员。
> 我无法重写世界,异步运行时和Web服务器对我来说太过复杂且耗时,无法为这样的项目 justify 编写(尽管我最终应该这样做以获得更好的理解)。
我这样做了,但只解决了膨胀问题的一半:
https://crates.io/crates/safina——安全的异步运行时,6k 行
https://crates.io/crates/servlin——模块化 HTTP 服务器库、线程处理程序和异步性能,8k 行。
我使用 safina+servlin 和 1,000 行 Rust 代码在廉价的虚拟机上运行 https://www.applin.dev。它提供一些静态文件、一个简单的表单,接收 Stripe webooks,并与 Postgres 和 Postmark 进行通信。它依赖一些沉重的 crate 树:async-fs、async-net、chrono、diesel、rand (libc)、serde_json、ureq 和 url。
在项目目录中运行 `cargo vendor` 可以下载 2,088,283 行 Rust 代码。
使用 https://github.com/coreos/cargo-vendor-filterer 尝试仅下载 Linux 依赖项,命令为 `cargo vendor-filterer –platform=x86_64-unknown-linux-gnu`,共下载 986,513 行代码。这仍然会下载 `winapi` crate 和其他 Windows crates,但它们只包含 22k 行。
使用 `cargo vendor-filterer –platform=x86_64-unknown-linux-gnu –keep-dep-kinds=normal` 省略开发依赖项,共 976,338 行。
使用 `cargo vendor-filterer –platform=aarch64-apple-darwin –exclude-crate-path=‘*#tests’ deps.filtered` 排除测试后,行数为 754,368 行。
750k 行对于一个 1k 行项目来说太多了。我猜我还可以再花 200 个小时的工作时间来删除一些繁重的依赖项,最终可能会得到一些精简的 crates。我一直在等待有人编写一个好的线程化 Rust Postgres 客户端。
我已经接受了我并不是在“rust”中进行开发,而是在“tokio-rust”中进行开发,并且不再担心随处可见的异步问题(这与其他具有异步功能的语言并没有本质上的区别)。
为什么需要回到线程开发呢?
1. 异步 Rust 是工程师需要学习和记住的额外知识。
2.异步 Rust 有很多纸张切割。
3.实际上很少有代码需要异步。例如,在 API 服务器中,每个请求处理程序都需要数据库连接,因此并发性受到数据库的限制。
我用异步 Rust 编写了 Servlin HTTP 服务器来处理慢速客户端,但它调用的是线程请求处理程序。
我非常谨慎地严格控制 Tokio 的依赖关系。所有依赖关系都由 Tokio 团队成员或我信任的人控制。
出于好奇,我运行了用于计算代码行数的工具 toeki,发现 Rust 代码竟然有 360 万行。删除供应商提供的软件包后,Rust 代码行数减少到 11136 行。
在这 360 万行代码中,有多少行是测试代码?
您可以审核 crates 的依赖项,查看是否存在向 RustSec Advisory Database 报告的安全漏洞,还可以阻止未维护的 crates,并使用 cargo-audit 和 cargo-deny 中的 SPDX 表达式强制执行您的许可要求。
您可以使用 cargo-vet 确保第三方 Rust 依赖项已由可信实体进行了审核。
您应该看看这 300 万行代码来自哪里,它们通常来自 Microsoft 的 windows-rs crates,这些代码通过默认功能和在 Windows 上运行的 crates 的构建目标转而包含在您的依赖项中。
Rust 中真正让我感到惊讶的是碎片化和废弃库的数量。例如,serde_yaml 已存档,还有其他两个库做着相同(?)的事情。似乎需要花费大量精力来搜索和决定使用哪个库(如果有的话)。在 Go 中,这种情况并不明显。
是的,Rust 中的一个问题是,许多非常基本的生态系统库都是由少数知名人士编写的。他们通常也是标准库或 Rust 编译器的工作人员。Rust 开发人员通常都知道他们的名字和社交媒体账号。
这是一个问题,因为这些人会变得过度劳累,最终不得不放弃某些事情。serde_yaml的废弃是一个巨大的问题,尤其是在没有功能替代品的情况下。没有呼吁新的维护者,也没有人接手这个项目。我可以理解原因(现在你突然开始审查人,而不是代码),但这真的很糟糕。
也许这是将包管理器与语言深度整合的双刃剑。
cargo 与语言的整合程度如何比 Go 更深?我对 Rust 几乎一无所知,但 Go 的包管理在我看来已经非常完善了。
我们现在看到的(糟糕的)解决方案是生成式人工智能。你不需要导入库,而是让人工智能为你编写代码,人工智能很可能已经摄入了实现你所需功能的库,并会将该部分复制粘贴到你的代码中,使其与你的其他代码风格一致。
我认为这会带来更多问题而非解决问题,但它可以解决在你可以自己编写一个 10 行函数的情况下,却要添加数千行依赖代码的问题。
当然,正确的做法不是做那种错误的懒惰,而是要理解你在做什么。我之所以说“错误的懒惰”,是因为存在“正确的懒惰”,即不做不需要做的事情,而非草率地完成任务。
解决方案是通过编译时和运行时对代码行为的强保证。
作者说得对,个人无法审计所有代码。目前,所有代码都可以在开发人员的机器上在编译时运行任意构建代码,还可以在运行时运行任意不安全的代码、进行系统调用等。
软件并没有变得更简单,大量高质量的库对 Rust 来说是件好事,但供应链攻击在所难免。
人工智能和合作审计可以提供帮助,但最终编译器必须提供更多保证。未来添加的 Rust 应该附带一个不可避免的效果系统。Rust 已经开始研究效果,我不确定安全性是否是一个目标,但这是必须的。
> 许多人呼吁像 Go 一样为 Rust 标准库添加更多内容。
这是正确的做法。
应该有一个稳定性保证较宽松的第二个 stdlib。不要把正常的 stdlib 填满永远无法更改的垃圾。
实际上,昨天就发布了一个完全相同的提案:https://github.com/rust-lang/rfcs/pull/3810
遗憾的是,到目前为止,该提案的反响并不乐观。
该提案与这个提案并不完全相同;它似乎提出了一个“受祝福的 crates”命名空间,其中包括流行的开源库。我认为该提案是一个 Python 风格的“内置电池”标准库。
原帖提出的并非更大的标准库,因为他们提到应有“宽松的稳定性保证”。还是说Python允许以向后不兼容的方式修改标准库?
这种情况确实存在——在废弃期后,通常是小幅修改,但频繁发生(即每个小版本更新都会有某些人直接受影响)。最近甚至有整块模块被移除——尽管这仍属于保守变更,因为主要涉及本世纪几乎无人使用的罕见文件格式和协议支持(详见https://peps.python.org/pep-0594/ 详情——我可能有些夸张,但夸张程度不大)。
历史上这一过程大多是非正式的;未来他们正试图确保模块在废弃后特定时间点被移除。Python 现已采用年度发布节奏;结合废弃政策,这使得其版本控制体系 effectively 演变为一种伪-Calver 模式。
是的,他们确实定期这样做。每个版本都会移除多个旧版标准库功能(在最后一个未废弃的版本达到生命周期终止后)
所以我们又重新发明了 Java 的臃肿 SDK,包含所有 “javax” 包。旧的即是新的?
这就是为什么 “Java 的臃肿 SDK” 目前是全球编写关键软件最流行方式的原因。
或许因为这是一个好主意。
好吧,结果证明,替代方案更糟糕,所以……就把它当作学习经验吧。
我不在 Rust 社区内,所以我的意见毫无价值——但在这条帖子中,似乎很多人实际上想要的是一个事实上的应用程序框架,而不是一个臃肿的“厨房水槽”式的 stdlib。
我认为标准库应该保持简单。复杂性应该可选。
不,我们明确想要标准库,而不是应用程序框架。
第三方框架的问题在于,由于其本质(作为第三方框架),并不存在统一的标准版本可供使用,因此不同库会采用不同的框架,最终导致依赖关系混乱,或是出现多个相互不兼容的生态系统,每个生态系统都在围绕不同的框架重复实现相同的功能。
标准库(stdlib)的优势在于它始终存在,这意味着任何库都可以按需使用它。它还改善了库之间的互操作性,因为相同的概念由相同的标准类型表示。即使标准库的部分内容是可选的(出于必要性,任何“开箱即用”的标准库都必须如此,例如嵌入式系统就是一个例子),这对库作者仍然有益,因为他们知道,对于任何给定的功能,所有支持该功能的平台都会以相同的方式暴露标准库。
是的,我同意。就像 C++ 的 Boost 库一样。
这种方法的一个明显优势是,你不需要是 Rust 核心团队的一员就能做到。任何想做这件事的人都可以立即开始做。
我同意。遗憾的是,我认为许多要求扩大标准库的人实际上只是希望(a)有人来完成这项工作(b)有人值得他们信任。
从事 Rust 工作的人是一个有限的(可能超负荷的!)群体,你不能只是给他们增加更多的工作。“仅仅”扩大标准库可能根本行不通。
我认为,如果有一群人承担起这项艰巨的工作,整理出一套每个人都会使用的 crates,并为他们提供一个漂亮的界面,完全脱离 Rust 团队的保护伞,那将是很好的。然后,人们就可以开始使用这个 Katamari crate 来证明它的有用性。
然而,很多人不会使用它。我不会使用它,因为我根本不在乎,而且我很乐意一个一个地添加我的依赖项,只使用最基本的功能集。其他人不会使用它,因为它没有得到 Rust 团队的神秘祝福/认可。
让我们给它定个价吧
只有当 Rust 核心团队不合作时,这才是优势,这令人遗憾,而不是值得高兴的事情。
“Rust 核心团队”应该专注于“Rust 核心”的工作,而不是某个人认为应该纳入标准库的每件小事。说“不”是“核心团队”的工作的一部分。
很多很多。
真的很多很多。浏览一下任何有公开问题跟踪器的编程语言,看看所有已关闭的提案。单独来看,也许是一堆好主意。但把它们组合在一起呢?效果并不理想。
这显然是 Rust 的最佳解决方案。一个“金属库”库类型作为连接点,将为生态系统增添很多价值:
  - 可以测试所有包含的 crates 的互操作性
  - 以单一版本发布所有包含的 crates,简化升级
  - 作为演示集成和升级的活文档的示例项目
  - 重大更改可以等到所有受影响的 crates 都修复后再进行,然后一次性完成
  - 代码审查/覆盖率指标的可实现、有价值的本地目标
可能存在通用的“包罗万象”型元库、针对特定领域或行业的元库、采用不同稳定性或代码审查标准的元库等。甚至可能有足够价值提供支持和咨询服务…
非标准库,如果可以这么说的话。
不可能。我更希望我们拥有像谷歌的 Guava 这样的核心配套库群。
我们不需要给 Rust 添加像 Python 标准库那样过时的垃圾。Cargo 完全可以胜任这项工作。我们只需要一些高质量的可选电池。
嵌入式项目不太可能需要标准库的膨胀。No_std 应该成为每个人的首要考虑。
一些可能使附加库感觉更一流的东西:如果 cargo 最终获得了命名空间,并且如果 Rust 项目采用“@rust/”作为组织名称来推出官方认可和维护的软件包。
Python 的标准库是 Python 可用的主要原因。
Python 的打包系统就像一场持续了 30 年的火车事故,但标准库足够好,让我可以不依赖其他库或仅依赖少量库来完成大多数事情。
我认为,无论如何称呼它,额外的标准库层不需要像实际标准库那样对向后兼容性和演进施加严格控制。我认为创建它的目标应该是提高供应链安全性,而不是提供一个极度稳定的 API,后者可能在较低层次上更优先,但会阻碍未来所需的演进。
我认为你提议的这个想法非常适合作为新的标准库层,只是你没有使用这个标签。在Rust命名空间中的一组包,由同一群人维护,但遵循符合安全最佳实践的政策,并提供额外支持以满足这些最佳实践。这些包不应是必需的,因此no_std应与在这样的集合之前一样有效。
Python的垃圾回收机制在任何有完整CPython实现的地方都有效,我认为这是个优势。
我为 Linux、Mac 和 Windows 开发软件。多种架构和操作系统。我很少看到 Rust 存在平台问题。通常只有一些边缘的东西,比如 CUDA 库,才会影响跨平台构建。
作为系统语言,Rust 非常适合在各种系统上运行。
首先,Rust 不会支持 LLVM 上没有的架构,但 GCC 上有,否则 GCC 的 Rust 前端项目就不会存在了。
至于系统语言的评论,我仍然期待着,当对二进制库进行 ABI 问题分类时,最终无需通过为 C 和 C++ 设计的解决方案。
LLVM 中缺少的架构在今天具有商业意义,而不是已经过时了?
> 我们不需要给 Rust 添加像 Python 标准库那样过时的垃圾。
Python 标准库是一个优势,而不是弱点。Rust 应该感到幸运。无论发生什么情况,都能保证基本功能的存在,这是非常好的。许多人工作环境不允许他们随意从互联网上下载软件包,因此他们只能使用标准库中的功能或自己编写的程序。
> Python 的标准库是一个优势,而不是弱点。Rust 应该感到幸运。
Rust 更幸运。它采取了正确的方法。你可以在 crates.io 上找到你需要的每一个电池。
Python 有像 urllib、urllib2、http 等怪兽。所有这些都被外部请求库及其同类所取代,几乎被完全忽视了。标准库在调用约定和命名约定方面也存在不一致之处,而且它必须永远支持这些约定。
核心语言应该保持纯净。Rust 做得很对。你需要的其他一切都在触手可及之处。
“Rust 做得很对。”
每当有人批评 Rust 时,都会出现这样的标准回应。
bigstrat2003 的论点大致是“Python 包含电池”。
我的反论是,“包含电池”的方法往往会萎缩,成为死重。
你的反驳似乎是“这不是一个论点,只是 Rust 的炒作”。
我的理解正确吗?因为我认为我的论点是突出的,也是正确的。我不想被标准库中 20 年来积攒的过时 API 束缚。
Python 标准库是模块的坟墓。它有两个没人再用的测试框架,还有多少个 XML 库?七个?(正确答案是“四个”,我认为。而四个也太多了。)Python标准库里有太多垃圾,无法安全地移除或清理。
标准库应该包含数据结构/集合、文件系统/操作系统库,以及可能的网络库。仅此而已。其他内容变化太过频繁,不适合打包进去。
你的批评与Python用户的现实不符。
有一个单一的datetime库。它覆盖了98%的使用场景。如果你想要最后2%的全部功能,你可以下载它。有一个单一的JSON库。它几乎可以满足你想要的任何需求。如果你想要更快但可用性有所妥协的库,你可以使用它,但我从未觉得有必要这样做。
CSV、文件系统访问、数据库API等也是如此。它们并非你在编写脚本时“最好的”库,但现实是,你从未真正需要过“最好、最人性化的库”来完成任务。
正因如此,许多大型复杂包如Django几乎没有外部依赖。
如果你遇到日期API问题,那不是你的错; 而是Python核心开发者。其他包的维护者可以自由选择其他依赖项,但他们几乎无一例外地发现,Python标准库已经足够应对一切。
Python的datetime库是遗留软件,其易用性、安全性都糟糕透顶,还布满了可怕的陷阱。这是我最不喜欢的库之一。
https://dev.arie.bovenberg.net/blog/python-datetime-pitfalls…
但现在你将永远被它束缚。
Python 充斥着这类问题。因为它缺乏周密的规划,且未对那些将影响长远的决策给予应有的重视。
Python 内置了两个测试框架,但两者都不够理想。
Python 历史上一直存在质量低下的 HTTP 库,由于无法移除或修改旧版本,不得不发布多个新版本来修复问题。初学者在使用该语言时会发现这些内置库,并可能在开发新软件时沿用这些过时组件。
“内置电池”是一种软件缺陷。这种设计很糟糕,因为即使电池过期也无法更换。
> Python 的 datetime 库是遗留软件,其易用性、安全性都非常糟糕,还存在诸多陷阱。这是我最不喜欢的库之一。
你的论点似乎来自一个缺乏大型系统软件工程经验的人。
所有大型软件系统和大多数有效的软件都使用并非特别现代且不一定是最好的库,但它们是被充分理解的。
在你的日期时间库示例中,注意作者立即忽略了那些曾经比标准库更好的库,但现在已不再维护。这本身就是一个红旗;如果一个库存在被放弃的风险,那么它是否更好并不重要。
请注意,在提到的例子中,没有单一的库能解决所有问题。而且,没有任何一个日期时间库在任何地方都能提供一致、统一且数量级上的改进,以至于值得放弃标准库。
标准库是“足够好的”。你可以构建功能良好的商业系统,只要你对日期时间的使用有基本的了解,大部分情况下都不会有问题。我使用 Python 已有超过 15 年,每次选择不同的日期时间库都只是增加了额外的维护负担。
> 但现在你将永远被它束缚。
你选择的任何日期时间库都会让你“陷入困境”。总有一天,你那所谓的“伟大”日期时间库会成为遗留系统,而你在迁移到更好方案时同样会陷入困境。
我听过类似论调针对SQLAlchemy、Django ORM及其他包。那些选择维护不足方案的人现在也陷入了遗留模式。
> Python 充斥着这类问题。因为它缺乏周密的规划,且未对那些需要长期使用的决策给予足够重视。
这是纯粹的无知。没有一个语言的标准库是绝对完美的。然而,从工程角度权衡利弊后,内置工具包的方案长期来看仍是更优选择。
> Python 内置了两个测试框架,但两者都不算优秀。
它们已经足够好用。它们拥有广泛支持和大量插件。它们支持断言。它们抓住了核心要点,我成功让有用的测试通过。这才是关键;你的测试不会因为你选择使用 nose 或其他流行框架而突然变得更好。
> Python 历史上一直拥有糟糕的 HTTP 库,并且不得不发布多个版本来修复旧版本,因为无法打破或移除旧版本。语言新手会发现这些内置库,并用旧版本的包来编写新软件。
当前的 Python 文档推荐使用 requests,而 requests 是一个成熟的包,被广泛使用且不会过时,因为它已经成为标准超过十年。这没问题。如果你是库作者,最好使用 urllib3 并避免额外的依赖。
> “内置电池”是软件的臭味。这很糟糕。即使电池过期了,你也无法更换它们。
试着复活一个十年前用 Node.JS 编写的业务应用程序,它有数百个过时的依赖项。一个等效的 Python 应用程序最多只有六七个依赖项,如果你坚持使用最流行的包,升级过程很可能非常顺畅和简单。我已经做过多次;许多同事也经常不得不这样做。Python 的决策让这变得极其容易。
抱歉,如果你追求库的完美,你就不是在追求可维护的软件。软件质量是整体的,而不是选择最现代的东西。
> 标准库在调用约定和命名约定上也存在不一致,而且它必须永远支持这些。
更不用说那些受90年代和00年代货运崇拜式“面向对象编程”(OOP)Java框架启发的糟糕设计。(来吧,各位。面向对象编程本应关注的是对象,而非类。如果它关注的是类,那它应该被称为类导向编程。)
问题在于如何让所有人就其工作方式达成一致,例如扩展的标准是什么,未来变更的政策是什么,谁将维护所有这些内容,等等。
现在,你不再需要在自己的程序中看到数百万行难以理解的代码导致二进制文件体积膨胀,而是可以在每个程序中看到(只要该程序未禁用标准库)。
在每个使用标准库特定功能的程序中。面对相同的功能,我更倾向于信任标准库而非某个随机项目。如果你不信任 stdlib,为什么还要信任编译器呢?
这对维护者来说是一个沉重的负担,会带来各种问题,尤其是当库的功能需要特定的执行环境时。Rust 并不只针对 x86 桌面。
Go也不仅仅针对x86桌面系统
那又怎样?并非每个项目都有相同的资源。
这里存在权衡。拥有一个庞大但维护不善、平台支持不一致的标准库,比拥有一个较小但维护良好的标准库更糟糕。
从数字上看,Golang 有 2000 多名贡献者,而 Rust 有 5000 多名贡献者。
Golang 的核心开发团队大约有 30 人。
因此,Rust 确实拥有资源。
贡献者的数量是一个完全毫无意义的指标。
1. 并非每个贡献者都贡献相同。有些贡献者全职从事该项目,有些贡献者每月只工作几个小时。
2. 贡献者的数量并不能说明实际需要多少资源。毫无疑问,Rust 比 Go 更复杂,发展也更快。
- 贡献者数量无法反映维护生态系统中非常小众部分的贡献者数量。
确实,有时这会带来一些冗余。
然而,我更愿意接受在工具链完全实现时无处不在的冗余,而不是在仅支持某些平台时与第三方库玩“打地鼠”游戏。
我认为,Rust 中简陋的 stdlib 是一个巨大的错误。我希望看到这个问题得到纠正。遗憾的是,只有大约 5 个人赞同我的观点。Rust 社区整体上非常反对为 std 添加功能。
我的意思是,反对它的理由相当充分。许多拥有最大化标准库的语言都存在大量无人使用的冗余代码,因为生态系统已经找到了更好的解决方案。然而,这些代码必须永久维护。
C++标准库甚至在如此基础的功能(如格式化,iostreams)上也存在这个问题,现在它为同一个问题提供了两种解决方案。
当我开始使用 Rust 时,我也曾有过同样的担忧,但最终我还是接受了它,无论好坏。Cargo 使你的构建几乎不会出现故障(在我使用 Rust 的 8 年里,可能只发生过两次)。此外,尽管依赖项数量多得惊人,但 Rust 项目的漏洞仍然远少于非 Rust 项目。
如果我要设计 Rust 2.0,我会让依赖项需要获得访问 IO 或不安全代码等的权限。
当我编译 Rust 应用程序时,我必须承认,我总是对拉取的依赖项数量感到困惑。即使是我认为简单的工具,也轻松达到 200 个依赖包。这简直是一场噩梦。如果你想为 Guix 或 Nix 创建一个可重复的包,这一点就显得尤为明显。由于这些系统要求可重复构建,你最终必须为每个不同的 Rust 库手动指定一个包。为软件编写 Guix 包的过程让我深刻地认识到,某些技术与其他技术相比,其嵌套程度有多深。我敢打赌,这可能是衡量软件能否持久的良好指标。如果你的软件有200个依赖项,我认为它很难经受住时间的考验。这似乎是导致无休止更新的配方。
抱歉我没什么可补充的,但有两个有趣的参考资料供大家查看,当然,如果你感兴趣的话:
a) Ginger Bill(Odin语言的创建者,与我无关)在播客中表示,Odin将永远不会有官方的包管理器,因为在他看来,他们主要在自动化的是依赖地狱,而这正是软件复杂性上升和软件质量下降的主要原因之一; 参见 https://www.youtube.com/watch?v=fYUruq352yE&t=11m26s(时间戳已设置为正确位置)(他们明确提到了 Rust 作为例子)
b) 另一位对软件质量/复杂性深感担忧的程序员是 Jonathan Blow,他关于“防止文明崩溃”的演讲值得一看,我认为:https://www.youtube.com/watch?v=ZSRHeXYDLko (它并非专门讨论包管理器,但与软件复杂性/质量的整体议题相关)
附录:抱歉,我觉得现在几乎所有人都知道这个xkcd了,但到目前为止似乎还没有人发布过;“必备的xkcd引用”:https://imgs.xkcd.com/comics/dependency_2x.png
> a) 姜比尔(Odin语言的创建者,无任何关联)在播客中表示,Odin将永远不会拥有官方的包管理器
人们认为 Rust 在编译时阻止你解引用已释放的内存是语言作者过分的干涉,而同时又故意让用户难以重用代码,因为他们可能会做出他不喜欢的工程决策,这种认知上的矛盾令人震惊。
> a)… 奥丁将永远不会拥有官方的包管理器
或许这解释了为何奥丁能获得如此广泛的使用和 popularity。/s
> b)… 乔纳森·布洛(Jonathan Blow)的演讲《防止文明崩溃》
如此宏大的标题,在我第一次观看前以为一定是讽刺。结果证明,这是给轻信者准备的。我认为乔纳森·布洛对“软件质量/复杂性”的担忧,远不如他自诩为“最后的希望”来得认真。至少布洛的软件在其领域内取得了成功。然而,我担心布洛的问题是所有知识分子的通病:“知识分子是在一个领域有专长,却在其他领域发表意见的人。” Blow 对领域之外的软件有许多看法,但在我看来,他对自己的领域与你的领域为何不同几乎毫无好奇心。
我个人认为,几乎没有证据表明这是软件质量问题,任何此类说法都需要将 Rust 模型与据称“更好的”替代方案进行比较。复杂的软件需要许多人共同创作,有时甚至跨越时间和空间的距离,因此必然存在并需要依赖性。
有人能给我指出 ffmpeg、VLC 和 Samba 依赖关系与任何足够复杂的 Rust 程序(甚至可能有更多依赖关系)之间的实质性质量差异吗?
     ~ ldd `which ffmpeg` | wc -l
     231
现在,大型软件依赖关系图很可能是一个“安全问题”,但这是所有其他软件都普遍存在的问题。
“或许这解释了为什么 Odin 获得了如此广泛的使用和流行。/s”
这是一个对他人工作不必要的刻薄和轻蔑的评论。
  - 我认为在某个特定领域,Odin正逐渐为人所知并得到应用
  - 你应该明白使用`Odin包`只是将程序放入子文件夹而已
  - 它自带丰富的标准库和供应商库
  - 难道不是由创建者自行决定如何设计和推广他们的语言吗?
我甚至认为,一种语言不把自己吹捧为“万能解决方案,无论如何都要使用我”的技术是值得称赞的。创作者本人告诉人们,它可能不适合他们/他们的用例,鼓励他们尝试其他语言,有时甚至直截了当地告诉他们 Odin 不适合他们的需求,而 xyz 可能更合适。
Odin在语言设计和目标上是务实且有主见的。也许缺乏包管理器是你忽视一种编程语言的原因,但对许多其他人(以及很可能更多Odin的目标群体)来说,这在选择语言时是最不重要的考虑因素。
> 这是对他人工作的一种不必要的刻薄和轻蔑的评论。
刻薄是故意的,但对 Ginger Bill 的努力持轻蔑态度并非本意。然而,当你做出“Odin 永远不会有包管理器”这样的决定时,你可能是在选择让你的项目陷入小众地位,在这个时代。小众地位没问题,但它本质上意味着受众有限。就像“这款游戏永远只会是文字冒险类 roguelike”一样。
现有讨论在https://news.ycombinator.com/item?id=43930640
Rust 有无数种方法可以解决特定的问题,因为它不带主观意见,并在需要时将你带到最低级别。除此之外,还有无数种方法可以编码你的类型。还有无数种方法可以绑定 C 库。
解决方案空间基本上是无限的,这对系统编程语言来说是一件好事。Rust 能够达到如此高的水平,真是令人惊叹,我认为,易于使用的包管理器和活跃的 crate 生态系统是其中重要的一部分。
有时,我希望有一种更高级的类似 Rust 的语言,它有垃圾收集器、无需指定特性的通用函数和 D 的内省功能,而且非常固执。
你试过 Go 语言吗?
这里没有提到二进制大小(除了链接到一篇关于该主题的 ClickHouse 博客文章)。
代码行总数当然重要,但就实际应用而言,编译时间和二进制文件大小更为关键。
我不清楚Rust的情况,但在JavaScript领域,可树摇动(或可进行死代码消除)的库与不可树摇动的库之间存在明显界限。如果你坚持使用可树摇动的依赖项,最终打包的输出只会包含你实际需要的代码,并且可以非常小。
> 代码行数确实重要,但对于大多数实际应用而言,编译时间和二进制文件大小更为关键。
也许对于大多数实际用途而言是这样,但对于文章作者更关注的安全性而言却并非如此:
出于好奇,我运行了用于计算代码行数的工具 toeki,发现 Rust 代码竟然有 360 万行……我怎么可能审核完所有这些代码呢?
树摇动对此无能为力。
与许多编译型语言一样,Rust 对所有内容都进行死代码消除。
没错,但这取决于代码的编写方式,对吗?
如果你主要使用自由函数,那么一切都会自然地摇动;如果你使用大量动态调用,那么你会拉入一些不会被调用的东西。
Rust 即使对非自由函数也进行静态调度。只有 trait 对象才会被动态调度,而且大多数人认为它们在 Rust 中是被低估了,而不是被高估了。
如果这确实成为问题,还有 https://github.com/rust-lang/rust/issues/68262 这样的技术。
所以问 HN:OSGi 到底发生了什么?这种架构是否解决了问题,如果没有,为什么?
https://docs.osgi.org/specification/osgi.core/7.0.0/framewor…
“OSGi如何改变了我的生活”(2008) https://queue.acm.org/detail.cfm?id=1348594
这是我第一次接触OSGi。在我看来,“乐高假设”反映了一种日益合理的做法。ACM Queue文章提到了热插拔和依赖注入,而本帖子中的评论[0]提到了Sans IO。这与能力相关,既作为安全措施,也作为模块化方法。共同的主题是,程序应以强烈的边界意识编写:无论是包含的内容还是不包含的内容都至关重要,而边界必须允许内部与外部进行通信。将依赖关系推送到边界并从中创建接口。适用于简单可插拔组件的一般原则现在都已存在。需要更多像OSGi这样的努力来将原则付诸实践。
[0] https://news.ycombinator.com/item?id=43944511
我曾经坚定地站在组件导向阵营。但事实是,概念(心理)模型并不能真正反映使用可重用组件进行组合的现实。
所有乐高组件都采用相同的简单标准机制:通过组件的凹面和凸面元素实现摩擦耦合。Unix管道是我们最接近乐高式方法的实现,而“将字节管道从源头连接到目标”的模型实际上反映了软件中发生的情况。
在组件和API中,除非我们依赖某种通用基线(如REST的“动词”等小型有限语义API),该基线能够对任意函数调用进行序列化和反序列化(‘do (func, context, in-args, out-args, out-err)’),否则乐高比喻会迅速失效。
第二个问题是组件之间“交互”的模式。这是我第一次接触“Sans-IO”(/g),但它只是通过强制规定“组件之间不允许交互”来解决交互问题。因此,软件中的乐高模型:虽然整体上很好地表达了所需的简洁性,但作为一个生成性概念却远非有效,甚至可能有害(因为它过度简化了问题)。
现在我们有两种不同的软件技术,它们在某种程度上实现了组件化:使用一组预定义的组件来构建通用软件。一种是图形用户界面(GUI)组件,其中使用一组有限的视觉组件和操作构造(如“用户事件”等),这些组件具有结构和行为语义,用于创建任何领域的任意视觉界面。另一种是万维网(WWW),其中HTTP的REST动词也提供了一组有限的“组件”(这里是架构层面的),用于创建任意服务。在两种情况下,都存在将领域语义映射到结构化组件的繁琐且痛苦的过程。
因此,我们可以获得可重用的组件化软件(生态系统),但我们需要明白(基于图形用户界面和网络应用的经验),大量(语义)胶水代码和基础设施是必要的,就像图形用户界面需要大量连接线,网络应用需要大量代码框架一样。这就是OSGi之类的技术所带来的价值。
这进而引发了组件边界和粒度的问题。在DCOM和JEE等技术中,细粒度的组件被聚合在进程边界内。当前的思路是将进程边界视为组件边界(如Docker、K8s、微服务),并在这一过程中淘汰“应用服务器”。
> 对于组件和API,除非我们依赖某种通用基线(如REST的“动词”这类小型有限语义API),能够对任意函数调用进行序列化和反序列化(“do (func, context, in-args, out-args, out-err)”,乐高比喻很快就会失效。
我同意这通常是发生的情况,我建议我们应该走一条更好但更艰难的道路。编程工作可以被视为翻译,我们随处可见这种现象:正如你所说,将领域语义(做什么)映射到结构化组件(如何做),以及编译器,如RPC存根生成。因此,尽管RPC/REST/单向异步IPC等少数动词属于机器的领域,但我们程序员并不擅长处理这些。然而,要达成共识并不容易,这是我无法回避的问题。我希望我们能直面标准化问题。API 应该易于定义和标准化,这样我们就能使用类型丰富的 API,并享受其带来的所有好处。有一个古老的梦想,就是让程序像过程一样组合。如果我们解决社会问题,这是可以实现的。
> 第二个问题是组件之间“交互”的模式。这是我第一次接触“Sans-IO”(/g),但这只是通过强制规定“组件之间不允许交互”来解决交互问题。这就像软件版的乐高:整体上很好地表达了简洁性,但作为一个生成性概念,它远非有效,甚至可能有害(因为它过度简化了问题)。
我不确定你的意思,所以可能在跑题,但Sans IO、能力、依赖注入等更多是关于编写单个组件,而非组件间的代码。缺乏IO的部分和具有IO的部分仍然被打包在一起(例如组件作为进程)。有一种更广泛的模式,其中控制本地组件子系统的人决定将IO管理器放置在哪里。
> 现在我们有两种不同的软件技术,它们在某种程度上实现了组件化:使用一组预定义的组件来构建通用软件。
> 因此我们可以获得可重用的组件导向软件(生态系统),但需明白(借鉴 GUI 和 Web 应用的经验),大量(语义)胶水代码和基础设施是必要的,正如 GUI 需要大量连接线,Web 应用需要代码框架一样。
我同意,这就是为什么我想将基础组件与更强大的抽象分离,将前者交给机器(框架),后者留给我们。HTTP本身范围有限,是否意味着我们无法为服务提供更语义适配的接口?真正的问题是这些接口难以标准化,而非人们不愿创建它们。
> 我同意,这就是为什么我希望我们将基础组件与更强大的抽象分离,将前者交给机器(框架),后者留给我们。HTTP本身范围有限,是否意味着我们无法为服务提供更语义适配的接口?真正的问题是这些接口难以标准化,而非人们不愿创建它们。
在技术分析层面,我们大致达成共识。让我们聚焦于“经济性”这一具体指标和“自然秩序”这一模糊指标。
关于后者,考虑一下这样的想法:“也许接口难以标准化是因为这是一个虚假的乌托邦?”
关于前者,实际的关键指标是:“是创建一次性且临时性的系统更经济,还是将一个非常‘困难’任务的成本摊销到1或2代软件系统和工人中更经济?”
如今,行业用实际行动投票,通过博客宣传“新鲜工程师”的理念,而这些工程师对组件化方法缺乏深入理解。这种反响包括“NoSQL”运动,从历史角度看,其实质是受经济因素驱动的转变,其中也夹杂着一些黑天鹅事件,如Linux和容器化技术。然而,基于这种方法构建、部署和编排系统的复杂性所带来的“成本”,正导致工作者面临信息过载。如今,生成式人工智能的出现似乎进一步打破了经济平衡,使基于后期临时拼凑方法构建运行系统的做法更具优势。
至于为何使用“自然秩序”一词。目前最接近“乐高式”的系统是有机化学。艾伦·凯(Alan Kay)关于“像自然构建生物体一样构建代码”的愿景当然极具吸引力。我年轻时(建筑学院毕业后)也独立得出了类似观点,但当时未意识到、后来才明白的是,这种“自然秩序”之所以有效,正是因为涉及的规模和层次数量极为庞大!当然,也许我们可以让软件变得“有机”,但它自然会像生物系统一样给我们带来同样的困惑。我们真的完全理解我们的身体是如何运作的吗?
(只是在揭开旧的专业伤疤)
我想我还是会继续逆流而上。感谢这次讨论,它让我有了很多思考。
我同意 Rust 中存在太多依赖关系。我支持将一些更受欢迎的 crates 添加到 std 中的想法。许多应用程序都使用类似于 tracing、tracing-subscriber 以及基本服务器/客户端功能的东西。如果能在 std 中实现这些功能的简单、最小功能实现,那就太好了——类似于 Go 的做法。如果有人需要更复杂的系统,他们仍然可以使用外部 crate,但 std 中拥有基本构建模块确实会非常有用。
作者在此,感谢阅读并分享您的想法!这里还有一个较早的 HN 讨论帖,其中包含一些有趣的评论。https://news.ycombinator.com/item?id=43930640
Vendoring 是朝正确方向迈出的一步,你限制了方程的一侧。
但你仍然面临着错字占用和类似的问题,比如 crates 失去维护——文章提到了现在著名的 dotenv 与 dotenvy 问题(对于 crates 生态系统来说,更成熟的治理模式能否解决这个问题?此时,dotenv 可能应该被收回)。因此,在将一组基准依赖项进行供应商化之后,您需要进行全面的审计。
也许您可以利用大语言模型 (LLMs) 来缩小供应商化依赖项的大小/降低拥有成本。也许您可以只提取您需要的功能(但代价是什么,现在您可能难以回溯上游发布的修复程序)。也许大语言模型 (LLMs) 可以帮助审计过程本身。
您需要一个关于这些vendored依赖项上游修复的通知流。遗憾的是,在现实世界中,决策过程将比“哦,有个安全修复,我应该应用它”要复杂得多。
我一直好奇为什么像JFrog这样的公司不扩展其服务,提供“可信依赖项”或类似服务。即您付费外包依赖项治理和审计。当前产品中的 Xray 扫描是我所建议的全面性迈出的第一步。
不过,退一步讲,我会非常小心,以免因噎废食。Rust 凭借其类型系统实现,具有将无关开发人员的工作成果组合在一起的独特能力(想想 C 库会发生什么情况,谁负责释放内存,是你还是我?大规模组合是 Rust 的超能力,至少就大型企业的生产力而言是这样——在这种情况下,内存安全性并不是销售卖点,因为他们已经有了 Java 或其他语言。
我看到很多人对依赖关系抱有这样的担忧,主要是在 node 中。我确信这是一个问题,但我并不认为它像人们说的那样严重。我们有扫描工具可以自动帮助保持依赖项的安全性。如果你引入一个依赖项,而它不再被维护,这真的比你自己代码库中相关代码不再被维护更糟糕吗?
他们应该看看OPAM(OCaml的包管理器)。几年前在POPL或ICFP的OCaml研讨会上,有一场关于其工作原理的非常精彩的演讲。基本上,他们拥有庞大的持续集成基础设施,并保留了每个包的所有已发布版本。因此,一旦你为项目找到了合适的依赖项集合,就可以确信通过OPAM始终可以获取到确切的版本。
每个人都急于推出自己的项目,没有人有时间生成密钥、正确地对发布版本进行代码签名,并开始开发更安全的链。现在我们有了JS包“任意代码”生态系统,但这是针对Rust的。仿佛我们没有看到NPM在过去十年中被黑客攻击过多次。
> 每个人都急于推出自己的项目
这就是导致这么多问题的原因。
而且我们并不是在打仗或试图治愈下一次大流行病,我们只是在编写CRUD应用程序,并试图说服人们点击他们不需要的垃圾广告。
> 难道我们没有看到NPM在过去十年左右被黑客攻击过很多次吗?
这是什么时候发生的事情?我唯一记得的是event-stream事件,那已经是五年前的事情了?从我看到的来看,这似乎并不常见?
我看到两个问题:安全性和代码膨胀/编译器性能。后者在这里已经被讨论过很多次(链接器的初衷就是去除未使用函数,所以我觉得这不是大问题)。安全性是一个严肃且合理的考虑,但我们也依赖Linux和构建工具来构建东西。你怎么知道用于构建 Linux 的编译器没有被入侵,也许是在几代之前,现在你的 Linux 系统中存在一个不在 Linux 源代码中的后门?我记得有一篇研究论文讨论过这个问题。我们信任生态系统来验证我们使用的每个工具。我们也必须对自己的项目做同样的事情——只使用相关的内容,并进行依赖项卫生检查,以确保它们来自可靠的来源……
> 解决方案是什么?
语言中应提供一个完善的“内置工具包”标准库,并鼓励项目减少对第三方库的依赖。
JavaScript社区犯下的错误正在Cargo(以及任何过度依赖第三方库的项目)面前重演。
出于好奇,我运行了用于计算代码行数的工具 toeki,发现 Rust 代码行数高达 360 万行。删除供应商提供的软件包后,Rust 代码行数减少到 11136 行。
Tokei 已经 4 年多没有发布稳定版本了,在某些情况下会错误报告代码行数。作者过去曾表示,他们需要被付费才能回溯修复一条代码行,且该修复不会引发合并冲突,从而解决软件中的实际准确性问题……在我看来这很糟糕。
https://github.com/XAMPPRocky/tokei/issues/875
360 万行代码似乎太多了,让我产生了“你确定计算正确吗?”的怀疑。
我对 Rust 并不熟悉,但 Go 整个代码只有 160 万行。这包括编译器、标准库、测试等所有内容。
我当然不是怀疑作者的诚意,但也许有些无关的东西也被计算在内了?或者有些东西被计算了多次?或者下载工具出了问题?或者有大量生成的代码(系统调用)?或者……还有其他原因?我很难相信 Rust 中一些与网络相关的依赖项是 Go 总量的两倍。
另一个人从头开始编写了自己的异步运行时和网络服务器,以减少臃肿,但他们的 Rust 应用程序仍然有 200 万行代码:
https://news.ycombinator.com/item?id=43942055
听起来很多都是(生成的)系统调用相关代码?无论如何,这并不能真正解释问题。
这是 Rust 臃肿和编译时间慢的一部分原因。
但那里仍然有大量的依赖代码。
依赖和构建管理是软件工程中一个有趣且尚未解决的问题(从某种意义上说,这是核心问题)。
我一直在想,是否有一本好的现代参考书,能够提供对各种尝试过的方法的概念性概述或比较研究。
这是一个难以定义的主题,因为它贯穿了栈的多个层次(一直到编译器系统接口层),而大多数书籍都专注于一种语言或构建技术,而不是对所使用的方法进行更概念化的处理。
> 整个惨败让我思考……我到底是否需要这个 crate?35 行之后,我得到了所需的 dotenv 部分。
“一点复制比一点依赖更好。”——获取所需的部分,然后只在测试中包含库,以确保整个流程的一致性,我非常喜欢这个想法。
https://www.youtube.com/watch?v=PAAkCSZUG1c&t=9m28s
我认为主要问题在于,依赖项应能在自己的沙箱中运行,而该语言仅关注单体程序内的内存安全。
问题在于,如果你将库依赖项放在自己的沙箱中,库将拥有不同类型的接口(功能更为有限)
例如,如果我们查看沙箱边界,我们会发现:
– 部分依赖于语言权限控制(例如Java安全管理器)——这种方法最终被证明是一个非常糟糕的主意
– 进程边界,即利用操作系统强制执行的边界并进一步加固(例如通过承诺、cgroups等技术)——这种方法效果尚可
– 虚拟机边界(例如火花虚拟机)——效果良好
– 模拟边界(例如 WASM)——历史复杂,但如果与自我锁定的 worker 进程结合使用,效果可能很好
但这在实践中意味着,如果希望库依赖项可靠地沙箱化,那么调用方与库之间很可能需要更多或更少的进程间通信(IPC)边界
这意味着在实践中,它不适合很多场景
例如,对于大多数实用库来说,它非常不适合
例如,对于很多(但不是所有)数据结构库来说,它不适合,并且可能是一个大问题
例如,你可以将其应用于一个 Web 服务器,但然后你基本上是在重新发明 CGI、AGI,这可以接受,但性能上可能无法与之竞争
例如,你不能将其应用于一些基本的运行时引擎(例如Tokio),更糟糕的是,你现在可能需要为每个沙箱运行一个引擎的副本……(但你可以将其应用于Tokio内部的一些子部分)
人们已经以各种方式尝试过这种方法。
但到目前为止,这种方法在长期内总是失败。
如果基于WASM的最新尝试能取得长期成功就好了。
> 问题是,如果你将库依赖放在自己的沙箱中,库将面临一种截然不同的接口(功能上更加受限)
没有人说过这会容易。以借用检查器为例,它让内存操作变得更加受限,但有些人喜欢它,因为它让事情更安全。
谢谢!这是对现有沙盒技术为何无法在依赖项方面达到预期效果(就功能或性能而言)的非常详细的解释。
作为 Rust 开发者,我喜欢我们的依赖项,但我花了很多精力来修剪我想要使用的依赖项。如果我看到一个 crate 使用了太多的依赖项,我可能会为它做出贡献或寻找替代品。
如果你想使用依赖项,当你意识到它们也想使用依赖项时,我不会感到惊讶。但你可以把钱和时间花在正确的地方。投资于那些能做好事情的依赖项。
我到底需要这个 crate 吗?35 行之后,我得到了我需要的 dotenv 部分。
我并不是说你从 dotenvy 复制粘贴了这 35 行代码,但为了论证起见,假设你确实这么做了:现在,你无法自动从 dotenvy 修复这些行中的某些安全问题中获益。
无法从他们修复安全问题中受益,但也不会遭受
  - 他们破坏了某些功能
  - 供应链攻击
  - 他们做出的更改破坏了你的程序
  - 你意外依赖了他们代码中的漏洞或意外行为
    (他们可能随时修复这些问题)
  - 代码库中大量不需要的代码行
  - 责任的转移
    - 依赖第三方库与自行编写代码的区别
    - 在后者情况下,你将自动承担责任
    - 会更认真考虑代码的安全性和质量
    - 具备修复问题的能力并确切知道修复位置
      (在你自己编写的35行代码中)
  - 软件升级的负担更重
  - 更长的编译速度
- 需要监控程序
    - 是否被 abandon,所有权转移给可疑方
    - 维护者是否在深夜醉酒状态下接受了糟糕的 pull request
    - 是否对 CVE 做出反应
    - 是否更改了许可证
    - 是否添加了有问题的条款
    - 程序是否“开发不良”
      (以任何有问题的方式更改其目标范围)
      (承担越来越多的臃肿、越来越多的不必要功能)
  - 对您的总依赖性了解更差
    (因为它们本身可能依赖于您未预期的进一步 crates)
  - ...
现在的权衡是什么?
你忘了添加:法律顾问询问你为何使用一个随机包,该包触发了你最大客户合同规定的强制性安全审计。
什么安全问题?它只是按行读取文件,按“=”分隔,然后返回或调用setenv。我们讨论的不是OpenSSL。
要从中受益,你必须真正信任该包的当前和未来维护者、其依赖项、依赖项的依赖项等。你也可以在供应链攻击中自动被入侵,所以这是一个权衡
如果你真的需要这样的更新,你可以轻松订阅主流项目的更新(以任何它允许的方式),并在这种罕见情况发生时修复你的版本。
对于笔者来说,这是一个思想实验:想象一下,如果 Tokio(及其所有依赖项)被移到 Rust 标准库中,使其更像 Go。这会让他们更愿意依赖它吗(他们已经别无选择)?如果是的话,为什么?
Python现在也面临同样的问题,你无法轻松地全局安装包。我没有足够的硬盘空间来开发多个项目。每个项目仅依赖项就占用了数千兆字节的空间。
这是一个普遍问题:开发者引入库而不是编写几行代码。这些库又引入了更多依赖项,而这些依赖项又有更多的依赖项。
没有好的解决方案……
大语言模型(LLM)编码助手是一个部分解决方案。最近,我输入了
vec4 rgb2hsv(vec4 rbg)
,经过几次制表符补全后,它就用正确的颜色转换例程填充了代码主体。这让我省去了搜索和拉取一些庞大的颜色库的工作。
大语言模型(LLMs)也可以避免使用lodash.js的大部分功能。Lodash的循环比Javascript的语法更容易记忆,但如果你的LLM为你写了foo.forEach((value, key) => {…}),你就可以跳过语法糖库了。
为什么,提供一个补丁,引入几行代码并删除依赖项。
有人使用 cargo vet 成功过吗?
它让安全专业人员通过加密来保证 rust 包的可靠性。
多亏了 ChatGPT,我使用的库越来越少了。只要写出我当前需要的函数就行了。
那么 cargo vet 呢?
它让安全专业人员审核 Rust 包,并通过加密方式证明其可信度。
这似乎是一个毫无意义的问题。最好的办法可能是建立一个良好的信任模型,而不是责怪工具。
一个可移除的标准库似乎是最佳解决方案。它默认对所有人可用,但在嵌入式场景下可移除,仅保留核心语言特性。
正确
“不仔细考虑包管理会让我变得粗心。”
内存安全语言的意义不就是让程序员可以粗心大意而不会受到影响吗,即无需考虑内存管理,甚至无需了解内存的工作原理。
管理依赖关系会有什么不同吗?Rust 是否允许程序员无需仔细考虑依赖关系的选取?
> 难道内存安全的语言不是为了让程序员可以粗心大意而不会受到惩罚,即不需要考虑内存管理,甚至不需要理解内存的工作原理吗?
不。即使是使用不安全语言的最佳程序员,在正确处理内存时也会定期引入简单和微妙的错误,因此我们应该使用在绝大多数用例中都不允许这些错误的语言。使用这些语言仍允许糟糕的程序员浪费GB级正确分配和管理的内存,而优秀的程序员可以编写紧凑、资源消耗极低的代码。
依赖关系与此无关。
不,重点是阻止你粗心大意。如果你在内存管理上粗心大意,代码就无法编译。
你可以相对确定添加依赖项不会引入内存安全问题,但除非你对其进行审计,否则无法确定它不是恶意软件。
如果能够管理内存的谨慎程序员应该使用与无法管理内存的粗心程序员相同的语言,那么这是否意味着两者都应默认使用第三方库。
是否存在提供内存管理但不默认使用第三方库的系统语言?如果存在,这些语言是否能让程序员更容易避免依赖关系?
使用第三方软件的计算机用户需要防范程序员的错误。这可以通过避免使用粗心程序员编写的软件来实现。
这些程序员通常不需要保护,因为他们对使用他们匆忙编写的软件的计算机用户没有责任。
需要“保护装备”的是计算机用户,而不是犯下粗心错误的程序员。
> 粗心大意而不会产生影响
这是湿乱和干乱之间的区别。Rust 造成的是干乱。但仍然是一团乱。
保护装备的意义不就是让人们可以粗心大意而不会受到影响吗?
> 在检查一个提到 dotenv 未维护的 Rust 安全公告时
这是一个所有编程语言都存在的问题,而Rust在这方面表现尤为出色(得益于其版本控制机制)。你引入的包将像以前一样编译。对于垃圾回收语言(此处双关)而言,情况则并非如此。
出于好奇,我运行了toeki(一个用于统计代码行数的工具),发现Rust代码竟多达360万行……我该如何审计这么多代码?
再次,这是 Rust 表现卓越的另一个领域。您可以审核代码,最重要的是修改代码。如果您使用的是 Nodejs,其运行时在 node/v8 或其他平台之后,那么这并不容易。您可以自己编译这些内容(包括 TLS),并完全控制它们。这就是 Tokio 如此庞大的原因。
> 对于垃圾回收语言而言,情况并非如此
JavaScript 和 Java 一样,向后兼容性非常强,几乎可以追溯到永远。Rust 独特的系统能够对语言进行破坏性更改,而不会破坏旧代码,但这并不是说他们无限期地优先支持旧代码。
库的情况则不同——当你更新时,依赖旧版本库的东西可能会出现故障——但我认为 Rust 并没有真正解决这个问题。
> 你可以审核代码,最重要的是修改代码。如果你使用的是 Nodejs,其运行时在 node/v8 或其他版本之后,这并不容易。
Node 和 V8 是开源的,这使得代码与 360 万行的 Rust 一样可审核和可修改。也就是说,两者都是同样难以接近的。
> 库则是另一回事——当您更新时,依赖旧版本库的东西可能会出现故障——但我认为 Rust 并没有真正解决这个问题。
没有任何语言能解决这个问题。然而,我已经数不清有多少次因为某个依赖项的问题而导致我的 Python/JavaScript 解释失败了。通常情况下,这不是 JS/Python 的问题,而是与 Node/Python 版本更新有关。这总是归结为“核心”问题,即运行时。这就是为什么我喜欢 Rust 给我提供一个“固定”的运行时,我可以随我的程序一起下载/编译/打包。
> Node 和 V8 是开源的,这使得代码与 360 万行的 Rust 一样可审计和可修改。也就是说,两者都是同样难以接近的。
我最近在 Tokio/Otel 下修复了一个奇怪的错误,无法想象在 Node/V8 下做这件事不会遇到很大的麻烦。在 Rust 中,这相对简单,但需要维护你自己的分叉,而且只能维护相关依赖项/分支。
>你拉入的包将像以前一样编译。对于垃圾回收语言来说,情况并非如此(双关语)。
你是什么意思?
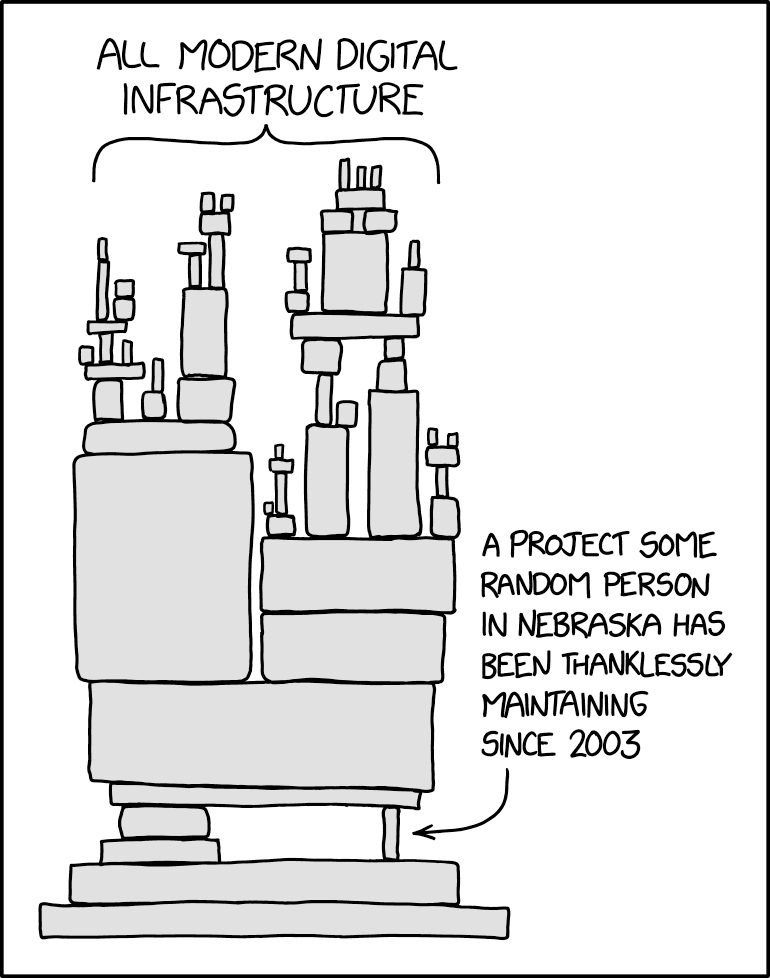
发表回复